AnythingLLM : discuter avec toute votre documentation éparpillée
AnythingLLM transforme un tas de fichiers Markdown, Quarto, PDF, DOCX, Excel et PowerPoint en quelque chose avec quoi vous pouvez réellement discuter, avec un modèle Ollama local derrière. La partie 1 l'installe sur une seule machine ; la partie 2 garde les documents sur mon PC de travail tout en empruntant le GPU qui dort à la maison.


Traduction automatique
Cet article fait partie de la série Ollama au quotidien :
- Installer Ollama et obtenir une IA locale
- Accéder à Ollama depuis votre réseau local
- ai-test : générer les tests unitaires manquants depuis votre terminal avec un LLM local
- ai-review, ai-secrets, ai-commit : trois vérifications zsh avant chaque git commit
- AnythingLLM : discuter avec toute votre documentation éparpillée
- ai-translate & ai-summarize : des documents confidentiels, traités 100 % en local
- ai-diagram : d'une phrase (ou d'un compose.yaml) à un diagramme Mermaid
- ai-data : laissez un LLM local écrire vos one-liners jq et awk
- ai-explain : l'ELI5 des scripts et des erreurs, directement dans votre terminal
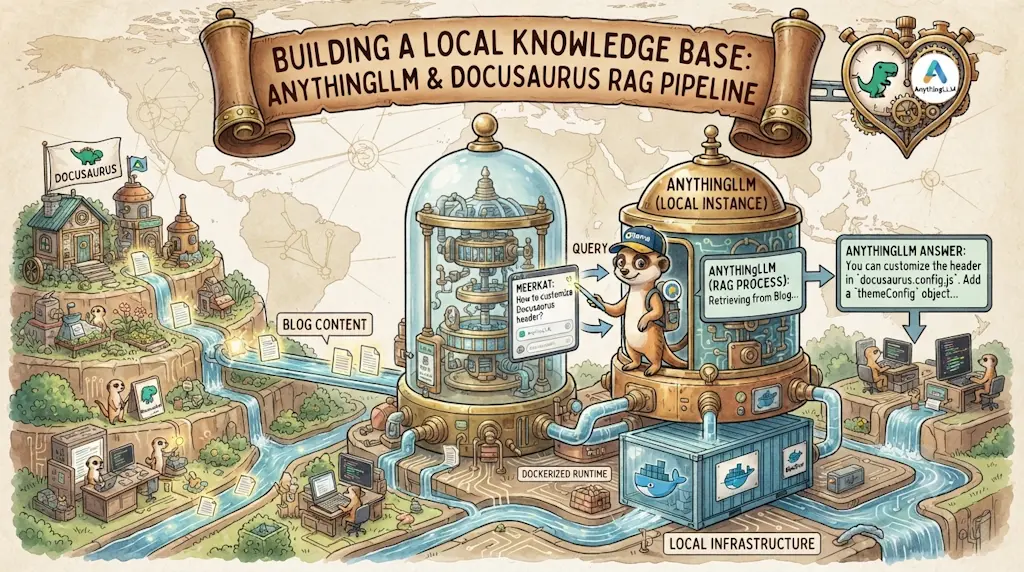
AnythingLLM est une application self-hosted, pensée pour Docker, qui transforme vos propres documents — Markdown, Quarto, PDF, DOCX, Excel, PowerPoint, peu importe — en une base de connaissances consultable et interrogeable, avec des réponses qui citent le fichier exact d'où elles viennent. Elle n'embarque pas sa propre IA : elle parle à un fournisseur de LLM de votre choix, ce qui lui permet de réutiliser un serveur Ollama que vous faites déjà tourner ailleurs. Cet article l'installe deux fois : une fois entièrement sur une seule machine (mon PC de la maison), et une fois répartie sur deux — documents sur mon PC de travail, inférence GPU sur le PC de la maison — parce que certains documents n'ont tout simplement pas le droit de quitter la machine où ils vivent.
Sous ~/repositories, sur mon portable de travail, j'ai des dizaines de dossiers de projets, et chacun a discrètement accumulé son propre tas de documentation : un README.md ici, un rapport Quarto là, une spec PDF que quelqu'un m'a envoyée, une feuille Excel dont personne ne se souvient de l'objectif, un PowerPoint issu d'une réunion d'il y a six mois. Pris séparément, chaque fichier va très bien. Ensemble, c'est un cimetière — je sais que j'ai noté quelque part la réponse à « comment j'ai configuré ce VPN la dernière fois », dans un de ces dossiers, dans un de ces formats, mais le retrouver suppose soit de me rappeler le nom exact du fichier, soit de faire un grep en espérant que les mots correspondent.
Si vous avez déjà ouvert un terminal, tapé grep -r "some term" ~/repositories, obtenu quarante résultats sans intérêt et abandonné — vous avez déjà le problème dont parle cet article.
Le voir fonctionner
Voici une vraie question posée à un vrai workspace — les 248 articles de ce blog, indexés avec le script plus bas. Poser la question, c'est un appel API, exactement la requête que le panneau de chat envoie quand vous tapez dedans :
Relisez la question et remarquez ce qu'elle ne contient pas. Pas chpwd. Pas for-each-ref. Pas committerdate. Même pas les mots du titre de l'article qu'elle a trouvé — Showing the last 3 updated branches when you jump in a git repo. J'ai décrit un souvenir flou avec les mots que j'emploierais réellement deux ans plus tard, et j'ai récupéré le mécanisme, le hook auquel il est branché, le flag qui trie les branches, et un lien.
C'est précisément la requête que grep ne peut pas servir. grep -r "chpwd" l'aurait trouvé instantanément — si je m'étais souvenu du mot chpwd. Tout l'enjeu, c'est justement que non.
Pourquoi ça fonctionne
- AnythingLLM est une application open-source, self-hosted, construite autour du Retrieval-Augmented Generation (RAG) sur vos propres fichiers, organisés en workspaces — un par projet, par client ou par sujet, sans aucune fuite entre eux.
- C'est un client, pas un LLM. AnythingLLM ne livre pas de modèle à lui : il appelle un LLM Provider que vous configurez : OpenAI, Anthropic ou, la partie intéressante pour nous, Ollama. Si vous faites déjà tourner Ollama quelque part, AnythingLLM n'est qu'une chose de plus qui lui parle.
- Chaque réponse revient avec une référence au fichier source et au chunk d'où elle a été extraite — une citation, pas une supposition qu'il faut croire sur parole.
- Il lit ce que
grepne peut même pas ouvrir : la spec PDF, la feuille Excel, le deck PowerPoint. C'est l'autre moitié de la raison pour laquelle il complètergplutôt que de le remplacer. Il coexiste aussi avec Open WebUI — Open WebUI est un client de chat généraliste pour Ollama, AnythingLLM est spécifiquement le layer de RAG documentaire, et les deux parlent volontiers à la même instance Ollama.
Ce que vous gagnez pour l'effort d'installation
Une question en langage naturel sur tout le contenu d'un workspace, avec le fichier source nommé dans la réponse. Cette seule fonctionnalité vaut les vingt minutes de configuration Docker ci-dessous — elle transforme « je sais que j'ai noté ça quelque part » en une vraie réponse.
Quatre choses suivent, et vous pouvez les lire dans l'ordre qui vous plaît :
- L'installer — un
compose.yaml, plus la vérification de trente secondes qui vous évite un embedder qui renvoie silencieusement du bruit. - Y faire entrer des documents — pourquoi il n'y a pas de bouton « indexer ce dossier », et le script qui a indexé 248 articles en 94 secondes.
- Chercher depuis le terminal — un
curl, puis la même chose sous forme de commande shell avec des résultats cliquables. - Documents ici, GPU là-bas — la répartition sur deux machines, pour les documents qui n'ont pas le droit de voyager.
Partie 1 — Installer AnythingLLM sur une seule machine
C'est le cas simple : AnythingLLM et Ollama vivent sur la même machine, mon PC de la maison avec 24 Go de VRAM disponibles.
Prérequis
On suppose ici qu'Ollama tourne déjà comme container Docker, comme je l'ai installé dans Installer Ollama et obtenir une IA locale. Rien de ce qui suit ne réexplique cette partie.
Le fichier compose.yaml
Fidèle à mon habitude d'un dossier par outil sous ~/tools, créons ~/tools/anythingllm/compose.yaml :
name: tools
services: anythingllm: image: mintplexlabs/anythingllm container_name: anythingllm cap_add: - SYS_ADMIN ports: - "3001:3001" env_file: - .env environment: - STORAGE_DIR=/app/server/storage - LLM_PROVIDER=ollama - OLLAMA_BASE_PATH=http://192.168.0.218:11434 - OLLAMA_MODEL_PREF=qwen2.5:14b-instruct - OLLAMA_MODEL_TOKEN_LIMIT=8192 - EMBEDDING_ENGINE=ollama - EMBEDDING_BASE_PATH=http://192.168.0.218:11434 - EMBEDDING_MODEL_PREF=mxbai-embed-large # mxbai-embed-large has a 512-token context — a larger chunk size makes # every single embedding call fail. Keep this comfortably under it. - EMBEDDING_MODEL_MAX_CHUNK_LENGTH=400 - OLLAMA_EMBEDDING_BATCH_SIZE=16 - VECTOR_DB=lancedb volumes: - anythingllm_storage:/app/server/storage restart: always
volumes: anythingllm_storage:Ce fichier Docker Compose définit un service appelé anythingllm qui exécute une application LLM. Il configure l'application pour utiliser Ollama comme fournisseur de modèles de langage et d'embeddings, en spécifiant les modèles à utiliser, les chemins d'accès aux services, et les paramètres de stockage et de traitement.
Avant de le démarrer, créez le fichier .env qu'il référence, qui contient un secret aléatoire utilisé par AnythingLLM pour signer les tokens de session :
$ echo "JWT_SECRET=$(openssl rand -hex 32)" > .env
À propos de cap_add: SYS_ADMIN
AnythingLLM utilise un Chromium headless en coulisses pour certaines fonctions documentaires et de web-scraping, et Chromium veut cette capability pour faire tourner son sandbox dans un container. C'est une concession de privilège plus large que ce que j'aimerais accorder par défaut — le projet a une discussion ouverte pour la remplacer par un profil seccomp plus étroit, mais à ce jour, SYS_ADMIN est ce qu'attend l'image officielle. Bon à savoir, pas de quoi perdre le sommeil sur un LAN domestique.
OLLAMA_BASE_PATH et EMBEDDING_BASE_PATH pointent tous les deux vers 192.168.0.218 — la même adresse IP de serveur maison que j'ai utilisée dans Accéder à Ollama depuis votre réseau local. Remplacez-la par l'IP de votre propre serveur. Notez que même si Ollama et AnythingLLM tournent ici sur exactement la même machine, j'utilise quand même l'IP du LAN plutôt que localhost — ce détail compte plus loin, là où il cesse d'être un détail pour devenir tout l'enjeu.
Téléchargez le modèle d'embedding côté Ollama avant de démarrer AnythingLLM — il est petit (quelques centaines de Mo) et indispensable pour que quoi que ce soit soit embeddé :
$ docker exec -it ollama ollama pull mxbai-embed-large
Alignez la taille des chunks sur le modèle d'embedding, sinon rien ne sera embeddé
EMBEDDING_MODEL_MAX_CHUNK_LENGTH ci-dessus est à 400 pour une raison. Lancez docker exec ollama ollama show mxbai-embed-large et vous verrez context length 512 — fixez la taille des chunks au-delà et chaque document échoue à l'embedding, avec Ollama Failed to embed: the input length exceeds the context length enterré dans docker logs anythingllm. L'interface ne donne aucun indice : l'upload réussit, le document apparaît dans la bibliothèque, et le workspace reste simplement vide. OLLAMA_EMBEDDING_BATCH_SIZE n'est que de la vitesse — la valeur par défaut de 1 envoie un chunk par appel HTTP, ce qui transforme quelques centaines de documents en un très long après-midi.
Vérifiez que votre embedder discrimine vraiment
J'utilisais au départ nomic-embed-text ici — c'est le modèle que tout le monde recommande pour ce travail. Il a embeddé les 248 articles sans une seule erreur, puis a répondu « il n'y a aucun article couvrant spécifiquement WordPress » à propos d'un blog qui contient un article intitulé Quickly install WordPress in just three commands.
Rien n'avait échoué. Les embeddings étaient simplement dénués de sens, et une stack RAG n'a aucun moyen de vous le dire : elle récupère les vecteurs les plus proches qu'elle trouve et les passe au modèle, quels qu'ils soient. Donc avant de faire confiance à un embedder, passez trente secondes à prouver qu'il sépare un texte proche d'un texte sans rapport :
#!/usr/bin/env python3"""Prove an Ollama embedding model separates related text from unrelated text.
python3 embedder-sanity-check.py mxbai-embed-large nomic-embed-text"""
import jsonimport mathimport sysimport urllib.request
OLLAMA = "http://localhost:11434/api/embed"
# The first two sentences say the same thing; the third is unrelated.SENTENCES = [ "Installing WordPress using Docker containers", "WordPress installation with Docker", "Powerlevel10k is a theme for the zsh shell",]
def embed(texts, model): payload = json.dumps({"model": model, "input": texts}).encode() request = urllib.request.Request( OLLAMA, data=payload, headers={"Content-Type": "application/json"} ) with urllib.request.urlopen(request, timeout=300) as response: return json.loads(response.read())["embeddings"]
def cosine(a, b): dot = sum(x * y for x, y in zip(a, b)) return dot / (math.sqrt(sum(x * x for x in a)) * math.sqrt(sum(y * y for y in b)))
for model in sys.argv[1:] or ["mxbai-embed-large"]: vectors = embed(SENTENCES, model) related = cosine(vectors[0], vectors[1]) unrelated = cosine(vectors[0], vectors[2]) print( f"{model:<20} dims={len(vectors[0]):<5}" f" related={related:.4f} unrelated={unrelated:.4f}" f" separation={related - unrelated:+.4f}" )Ce script teste si un modèle d'embedding Ollama peut bien distinguer des textes similaires des textes non-apparentés. Il envoie trois phrases à un modèle (deux sur WordPress et Docker, une sur zsh), reçoit leurs représentations vectorielles, puis calcule la similarité cosinus entre elles pour vérifier que les phrases apparentées sont plus proches que la phrase non-apparentée.
$ python3 embedder-sanity-check.py mxbai-embed-large nomic-embed-text

mxbai-embed-large    dims=1024  related=0.9536  unrelated=0.4591  separation=+0.4945
nomic-embed-text     dims=768   related=0.5910  unrelated=0.5377  separation=+0.0532
Deux phrases qui veulent dire la même chose doivent scorer bien au-dessus d'une phrase sans rapport. mxbai-embed-large les sépare de +0,49 ; sur ma machine, nomic-embed-text a atteint +0,05, ce qui est du bruit. Je n'ai jamais remonté la cause racine — les tags :latest et :v1.5 se comportaient de façon identique, et les réglages OLLAMA_FLASH_ATTENTION / OLLAMA_KV_CACHE_TYPE d'Ollama n'ont rien changé — mais le correctif ne dépend pas de la cause. Faites le test, et si la séparation est faible, changez de modèle plutôt que de questions.
Ensuite, démarrez AnythingLLM :
$ docker compose up --detach
[+] Running 1/1 ✔ Container anythingllm Started
Configuration au premier lancement
Rendez-vous sur http://localhost:3001 (ou http://192.168.0.218:3001 depuis une autre machine du réseau). L'assistant d'onboarding demande :
Onboarding AnythingLLM
- LLM Provider — sélectionnez Ollama, collez l'URL de votre serveur (
http://192.168.0.218:11434), choisissez le modèle que vous avez déjà téléchargé (qwen2.5:14b-instructtient confortablement dans 24 Go de VRAM à côté du modèle d'embedding) - Embedding Provider — sélectionnez Ollama à nouveau, même URL, choisissez
mxbai-embed-large - Vector Database — laissez la valeur par défaut, LanceDB ; il est embarqué, aucun container supplémentaire à faire tourner
- Create your first workspace — nommez-le d'après un vrai projet, pas "test"
Faire entrer vos documents
Dans le workspace, la boîte de dialogue d'upload accepte exactement le mélange que je décrivais plus haut : déposez un README.md, un rapport Quarto .qmd, un PDF, un DOCX, une feuille Excel, un deck PowerPoint — en sélection multiple, autant que le sélecteur de fichiers de l'OS vous laisse en prendre d'un coup. AnythingLLM parse chaque format lui-même ; vous n'avez rien à convertir au préalable.
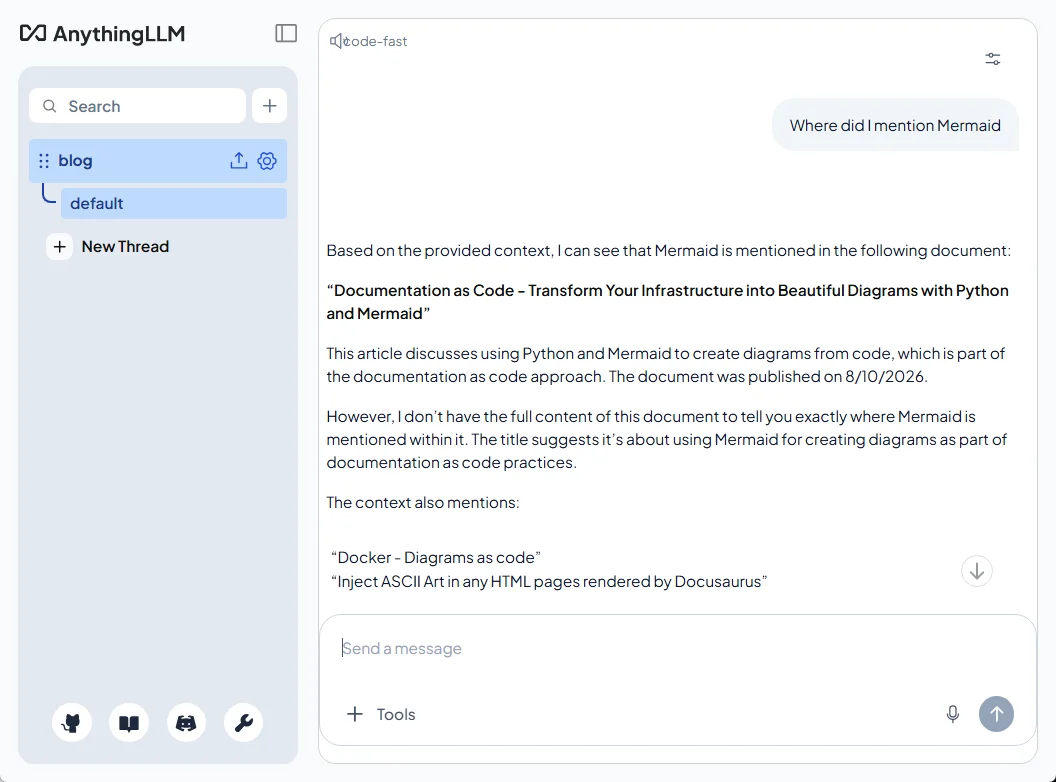
Dès que les documents affichent un statut « embedded » vert, posez une vraie question dans le panneau de chat — quelque chose que vous seriez normalement allé chercher à la main, exactement comme la preuve en terminal plus haut a obtenu sa réponse. La réponse revient avec le document source nommé à côté, donc vous pouvez aller vérifier au lieu de croire le modèle sur parole.
Vous ne lui donnez pas un chemin — et ça surprend tout le monde
C'est la partie que j'ai mal comprise la première fois, alors soyons explicites : il n'existe aucun champ, nulle part dans AnythingLLM, où vous tapez /home/me/repositories pour lui faire indexer ce dossier. Deux choses s'additionnent pour rendre ça impossible :
- Le serveur tourne dans un container, et le
compose.yamlci-dessus monte exactement un volume —anythingllm_storage. Votre dossier de documents n'existe tout simplement pas à l'intérieur de ce container. - Ajouter un bind mount n'aiderait pas non plus, parce que cette boîte de dialogue Upload est le sélecteur de fichiers de votre navigateur, qui tourne sur votre machine. Il ne peut pas voir à l'intérieur du container, et le container n'apprend jamais d'où vient le fichier — les octets arrivent en HTTP comme n'importe quel autre envoi de formulaire.
Donc AnythingLLM ne lit jamais vos fichiers là où ils sont. Il copie chacun d'eux dans son volume de stockage, le parse en JSON, le découpe en chunks et les embedde. C'est exactement le fait sur lequel repose toute l'argumentation de la partie 2 ci-dessous, et il vaut la peine de l'intégrer tôt : les documents vivent là où tourne le container.
Reste une vraie question : comment y faire entrer quelques centaines de fichiers sans cliquer quelques centaines de fois dans un sélecteur de fichiers ?
Indexer une arborescence entière avec une seule commande
L'interface graphique est l'une des trois portes, et les deux autres sont mieux adaptées au traitement en masse :
- L'API développeur — un endpoint REST qui prend un fichier par appel. Enveloppez-le dans une boucle et vous pouvez lui donner tout ce que vous savez trouver avec
find. C'est celle que nous allons utiliser. - Les data connectors (Settings → Data Connectors) — des importeurs prêts à l'emploi pour GitHub, GitLab, Confluence, Obsidian, ainsi qu'un crawler de site en profondeur. Si vos documents vivent déjà dans un repository, pointer le connecteur GitHub dessus ne demande aucun script. Donnez-lui quand même un token d'accès : sans authentification, il est bridé par la limite de débit publique de GitHub et ne récupère souvent que les fichiers de premier niveau.
- Le crawler de site web, si le contenu est publié quelque part. Le plus simple de tous, mais vous indexez du HTML rendu — navigation, pied de page et barre latérale inclus — au lieu de la source.
J'ai choisi l'API, parce que ce que je veux vraiment indexer, c'est ce blog : 248 articles, chacun un index.md dans son propre dossier daté. Générez une clé sous Settings → Tools → Developer API, et un seul appel ressemble à ceci :
$ curl -X POST http://localhost:3001/api/v1/document/upload \
    -H "Authorization: Bearer $ANYTHINGLLM_API_KEY" \
    -F "file=@blog/2026/08/17/anythingllm-chat-with-your-docs/index.md" \
    -F "addToWorkspaces=blog"
Le champ addToWorkspaces est ce qui en fait une opération en une étape : sans lui, le document arrive dans la bibliothèque de documents d'AnythingLLM mais n'est embeddé nulle part, et il faudrait encore aller cocher des cases dans l'interface.
Le piège : 241 fichiers nommés index.md
Docusaurus place chaque article dans son propre dossier sous le nom index.md, et AnythingLLM cite ses sources par nom de fichier. Uploadez-les tels quels et chaque réponse se termine par Source: index.md — 241 fois, impossible à distinguer. La citation est toute la raison d'utiliser cet outil, donc il faut corriger ça au moment de l'upload : curl permet de surcharger le nom transmis avec -F "file=@path/index.md;filename=the-slug.md", et le slug est juste là, dans le frontmatter.
Ça, plus le fait de sauter les fichiers inchangés depuis la dernière fois, c'est tout ce que fait le script :
#!/usr/bin/env bash## Index every blog post into an AnythingLLM workspace.## ANYTHINGLLM_API_KEY=xxxxxx ./anythingllm-index.sh## Re-run it after publishing a new article: only new and modified posts are# sent, everything else is skipped.
set -o errexitset -o nounsetset -o pipefail
WORKSPACE="${ANYTHINGLLM_WORKSPACE:-blog}"BLOG_DIR="${BLOG_DIR:-blog}"STATE_FILE="${STATE_FILE:-.anythingllm-indexed}"SITE_URL="${SITE_URL:-https://www.avonture.be}"
# The key can come from the environment (a line in ~/.zshrc) or from the# gitignored .env at the root of the blog — handy inside a devcontainer, which# doesn't inherit the host's shell configuration.if [[ -z "${ANYTHINGLLM_API_KEY:-}" && -f ".env" ]]; then ANYTHINGLLM_API_KEY="$(grep -E '^ANYTHINGLLM_API_KEY=' .env | head -1 | cut -d= -f2- | tr -d "\"'")" || truefi: "${ANYTHINGLLM_API_KEY:?Generate one in Settings > Tools > Developer API}"
# "localhost" is right when the script runs on the Docker host; from inside# another container it isn't, and the bridge gateway is what reaches it.if [[ -z "${ANYTHINGLLM_URL:-}" ]]; then for candidate in "http://localhost:3001" "http://172.17.0.1:3001"; do if curl --silent --fail --max-time 2 "${candidate}/api/ping" >/dev/null 2>&1; then ANYTHINGLLM_URL="${candidate}" break fi donefi: "${ANYTHINGLLM_URL:?No AnythingLLM instance answered on port 3001}"
api() { curl --silent --show-error \ --header "Authorization: Bearer ${ANYTHINGLLM_API_KEY}" "$@"}
# Read one key out of a Markdown file's YAML frontmatter, unquoted.frontmatter() { local key="${1}" file="${2}"
awk -v key="${key}" ' NR == 1 && $0 == "---" { in_fm = 1; next } in_fm && $0 == "---" { exit } in_fm && index($0, key ":") == 1 { sub("^" key ": *", "") gsub(/^"|"$/, "") print exit } ' "${file}"}
# Fail early and loudly rather than uploading 248 files into the void.if ! api "${ANYTHINGLLM_URL}/api/v1/workspaces" | jq -e --arg slug "${WORKSPACE}" '.workspaces[]? | select(.slug == $slug)' >/dev/null; then printf 'Workspace "%s" not found at %s (check the slug and the API key)\n' \ "${WORKSPACE}" "${ANYTHINGLLM_URL}" >&2 exit 1fi
# Replay the state file: post path -> "<sha256>\t<document location>".declare -A previous=()if [[ -f "${STATE_FILE}" ]]; then while IFS=$'\t' read -r hash path location; do [[ -n "${path}" ]] && previous["${path}"]="${hash}"$'\t'"${location}" done <"${STATE_FILE}"fi
declare -A current=()added=0updated=0skipped=0failed=0
while IFS= read -r -d '' file; do hash="$(sha256sum "${file}" | cut -d' ' -f1)" entry="${previous["${file}"]:-}" known_hash="${entry%%$'\t'*}"
if [[ "${known_hash}" == "${hash}" ]]; then current["${file}"]="${entry}" skipped=$((skipped + 1)) continue fi
if [[ "$(frontmatter draft "${file}")" == "true" ]]; then continue fi
# Every post is an index.md, so the folder name is what makes it # identifiable — send it as the filename AnythingLLM will cite. slug="$(frontmatter slug "${file}")" [[ -n "${slug}" ]] || slug="$(basename "$(dirname "${file}")")" title="$(frontmatter title "${file}")" [[ -n "${title}" ]] || title="${slug}"
# AnythingLLM stamps each document with a "published" date taken from the # temp file the collector received — i.e. the upload date, always today, and # not overridable through the API. Ask the workspace when something was # written and it answers confidently and wrongly. # Of the three fields copied into every chunk's header, "title" is the only # one we control, so the real date rides along inside it. published="$(frontmatter date "${file}")" [[ -z "${published}" ]] || title="${title} (published ${published})"
# A modified post: drop the previously embedded copy first, otherwise the # workspace ends up answering from two versions of the same article. if [[ -n "${entry}" ]]; then old_location="${entry#*$'\t'}" api --request DELETE "${ANYTHINGLLM_URL}/api/v1/system/remove-documents" \ --header "Content-Type: application/json" \ --data "$(jq -nc --arg name "${old_location}" '{names: [$name]}')" >/dev/null || true fi
# A "link://" chunkSource is the one metadata field AnythingLLM copies into # every chunk's header, so this is what lets the model answer with the live # URL of the article instead of just a filename. response="$(api --request POST "${ANYTHINGLLM_URL}/api/v1/document/upload" \ --form "file=@${file};filename=${slug}.md;type=text/markdown" \ --form "addToWorkspaces=${WORKSPACE}" \ --form "metadata=$(jq -nc \ --arg title "${title}" \ --arg source "${file}" \ --arg link "link://${SITE_URL}/blog/${slug}" \ '{title: $title, docSource: $source, chunkSource: $link}')")"
location="$(jq -r '.documents[0].location // empty' <<<"${response}")" if [[ -z "${location}" ]]; then printf 'FAILED %s: %s\n' "${slug}" "$(jq -r '.error // "unknown error"' <<<"${response}")" >&2 failed=$((failed + 1)) continue fi
current["${file}"]="${hash}"$'\t'"${location}" if [[ -n "${entry}" ]]; then printf 'updated %s\n' "${slug}" updated=$((updated + 1)) else printf 'added %s\n' "${slug}" added=$((added + 1)) fidone < <(find "${BLOG_DIR}" -type f \( -name 'index.md' -o -name 'index.mdx' \) -print0 | sort -z)
# Rewrite the state file from scratch so deleted posts drop out of it.for path in "${!current[@]}"; do printf '%s\t%s\t%s\n' \ "${current["${path}"]%%$'\t'*}" "${path}" "${current["${path}"]#*$'\t'}"done | sort -k2 >"${STATE_FILE}"
printf '\n%d added, %d updated, %d unchanged, %d failed\n' \ "${added}" "${updated}" "${skipped}" "${failed}"[[ "${failed}" -eq 0 ]]Ce script indexe les articles de blog dans un espace de travail AnythingLLM en envoyant les fichiers Markdown modifiés ou nouveaux. Il maintient un fichier d'état pour suivre quels articles ont déjà été traités, évitant de renvoyer les fichiers inchangés, et génère un rapport récapitulatif des opérations effectuées.
Créez d'abord un workspace nommé blog dans l'interface, puis lancez-le depuis la racine du repository du blog :
$ export ANYTHINGLLM_API_KEY=your-key-here
$ ./anythingllm-index.sh

added   docker-php-run-script-or-website
added   keepass-overriding-url
added   welcome
added   wslg-rpd-connection
added   docker-volume
added   apache-htaccess
...
added   ollama-test-generator
added   ollama-git-precommit
added   anythingllm-chat-with-your-docs

248 added, 0 updated, 0 unchanged, 0 failed
Une étape manuelle : le system prompt du workspace
Le script gère tout ce que l'API d'upload permet, mais il y a une chose qu'il ne peut pas atteindre : la façon dont le modèle lit ce qu'il reçoit. Collez ceci dans Workspace Settings → Chat Settings → Prompt — c'est ce qui fait sortir les dates correctes, et ce qui empêche le modèle de reconstruire des URLs dont il se souvient à moitié :
You answer questions about a personal technical blog, using only the retrieved excerpts.
Each excerpt starts with a <document_metadata> block. Read it as follows:
- "sourceDocument" is the article title. When it ends with "(published YYYY-MM-DD)", that is the article's real publication date.- "published:" is the date the article was fed to the search index. It is ALWAYS today's date and ALWAYS wrong. Never quote it, never mention it, never use it to compare or sort articles.- "source:" is the article's public URL. Use it verbatim; never invent or reconstruct a URL.
When you state a date, write it as DD/MM/YYYY.
Always answer in the language the question was asked in. When listing articles, give the title andthe URL of each. If the excerpts do not answer the question, say so plainly rather than guessing.Ce document explique comment répondre à des questions sur un blog technique personnel en utilisant uniquement les extraits récupérés, et comment interpréter les métadonnées de chaque document pour fournir des informations correctes.
Demandez en français, obtenez 02/03/2024
Avec ce prompt en place, « Quand ai-je publié l'article sur Tabnine ? » répond 02/03/2024 — bonne valeur, bon format, bonne langue. Sans lui, la même question renvoie 8/10/2026, 9:56:01 AM : le jour où j'ai lancé l'indexeur, dans un format américain que personne n'avait demandé. Sauter cette étape est le moyen sûr de finir avec un workspace qui a l'air correct et qui ment sur toutes les dates ; la dernière section explique d'où vient cette seconde date.
Garder l'index à jour
Une habitude à désapprendre avant de construire quoi que ce soit là-dessus : AnythingLLM ne rescanne jamais rien de lui-même. Un document embeddé est une copie figée ; modifier le Markdown original sur le disque ne change rien dans le workspace, et un fichier tout neuf lui est simplement invisible.
Il existe une fonction de synchronisation automatique, mais elle ne couvre pas ce cas : dans le déploiement Docker, elle ne surveille que les liens de sites web et les documents ramenés par un data connector. Les fichiers uploadés manuellement — tout ce que produit la route API — sont explicitement hors périmètre. (L'application desktop surveille bien les fichiers locaux, toutes les 10 minutes, mais seulement tant qu'elle est ouverte.)
D'où le fichier d'état que le script conserve. Le relancer, c'est la synchronisation :
Garder le workspace à jour
- Un nouvel article — son chemin n'est pas dans
.anythingllm-indexed, donc il est uploadé et embeddé - Un article modifié — son checksum ne correspond plus, donc l'ancienne copie est d'abord supprimée, puis la nouvelle uploadée ; sans cette suppression, le workspace répondrait à partir de deux versions du même texte
- Tout le reste — checksum inchangé, sauté sans aucun appel HTTP
Les chiffres plaident mieux que moi : indexer les 248 articles depuis zéro a pris 1 minute 34, et le second passage — où rien n'avait changé — a pris 0,26 seconde et fait exactement un appel HTTP, la recherche du workspace. C'est assez peu coûteux pour l'accrocher à chaque publication : une ligne dans votre script de déploiement, un hook post-commit, ou une entrée cron nocturne.
Un workspace par projet
Pour ma documentation dans ~/repositories, je garde quand même un workspace par projet plutôt que de tout déverser dans un seul — ça garde l'espace vectoriel focalisé, donc une question sur le projet A n'est pas diluée par des chunks sans rapport du projet B. Le script prend le workspace cible via ANYTHINGLLM_WORKSPACE, donc la même boucle couvre les deux organisations.
Chercher depuis le terminal
Avec 248 articles embeddés, le bénéfice est à un seul curl. Exportez la clé une fois — je garde la mienne dans ~/.zshrc, mais un simple export dans le shell fait aussi bien l'affaire — et interrogez le workspace :
$ export ANYTHINGLLM_API_KEY=your-key-here

$ curl -s -X POST http://localhost:3001/api/v1/workspace/blog/chat \
    -H "Authorization: Bearer $ANYTHINGLLM_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{"message":"Which articles cover devcontainers?","mode":"query"}' \
  | jq -r '.textResponse'

Here are the articles that cover devcontainers:

1. **[PHP development in a devcontainer with preinstalled code quality tools](https://www.avonture.be/blog/vscode-devcontainer)** (published 09/02/2024)
   - This article explains how to set up a PHP development environment using a devcontainer with preinstalled code quality tools.

2. **[Docker - Python devcontainer](https://www.avonture.be/blog/docker-python-devcontainer)** (published 30/10/2024)
   - This article guides you through setting up a VSCode devcontainer for Python development using Docker.

3. **[One Docker Image for Production and Devcontainers - The Clean Way](https://www.avonture.be/blog/docker-prod-devcontainer)** (published 13/10/2025)
   - This article discusses how to use a single Docker image for both production deployments and VS Code Devcontainers, emphasizing clean overrides and environment isolation.

4. **[Make your Quarto project Devcontainer-Ready — No More Setup Headaches](https://www.avonture.be/blog/quarto-devcontainer)** (published 03/11/2025)
   - This article explains how to make Quarto projects devcontainer-ready, using the `.devcontainer/devcontainer.json` file for configuration.

5. **[Level Up Your Presentations with Quarto, reveal.js, Decktape, Docker and DevContainers](https://www.avonture.be/blog/running-revealjs-with-docker)** (published 15/12/2025)
   - This article mentions using devcontainers for presentations with Quarto and reveal.js.

6. **[Running Docusaurus using Docker](https://www.avonture.be/blog/running-docusaurus-with-docker)** (published 11/11/2025)
   - This article discusses how devcontainers can be used to fine-tune environments, including VSCode extensions and editor settings.

7. **[Install a PHP Docker environment in a matter of seconds](https://www.avonture.be/blog/php-devcontainer)** (published 23/02/2024)
   - This article aims to create a development environment (devcontainer) for PHP.
Trois choses rendent cette réponse utile plutôt que simplement impressionnante :
"mode": "query"restreint le modèle à ce qu'il a réellement récupéré. L'autre valeur,"chat", lui permet de se rabattre sur ses connaissances générales quand le workspace n'a rien de pertinent — et c'est exactement comme ça qu'on obtient une réponse assurée sur un article que vous n'avez jamais écrit. Pour chercher dans votre propre corpus,queryest le réglage honnête.- Les URLs sont réelles, pas reconstruites. C'est le champ
chunkSourcedans le script : AnythingLLM copie les métadonnées préfixées parlink://dans l'en-tête de chaque chunk, donc l'URL réelle voyage avec le texte jusque dans le contexte du modèle. Sans ça, vous obtenez des noms de fichiers, et un modèle laissé à deviner des URLs les inventera avec plaisir. jq -r '.textResponse'suffit pour lire ; enlevez-le pour voir la charge utile complète, oùsources[]vous donne chaque chunk récupéré avec sontitle, sondocSource(le chemin dans le repo) et unscorede similarité.
ai-blog-search : le script portable
Taper ce curl chaque fois devient vite lassant, donc il vit dans un script — même résolution de clé/URL que l'indexeur, plus le formatage des sources :
#!/usr/bin/env bash## Ask the AnythingLLM 'blog' workspace a question and print the answer plus the# articles it came from, as clickable links.## ai-blog-search which articles cover docker?## Index first with .scripts/anythingllm-index.sh — this script only reads.
set -o errexitset -o nounsetset -o pipefail
WORKSPACE="${ANYTHINGLLM_WORKSPACE:-blog}"
if [[ "$#" -eq 0 ]]; then printf 'Usage: %s <your question>\n' "$(basename "${0}")" >&2 exit 1fiquestion="$*"
# Same resolution as the indexer: environment first, then the gitignored .env.if [[ -z "${ANYTHINGLLM_API_KEY:-}" && -f ".env" ]]; then ANYTHINGLLM_API_KEY="$(grep -E '^ANYTHINGLLM_API_KEY=' .env | head -1 | cut -d= -f2- | tr -d "\"'")" || truefi: "${ANYTHINGLLM_API_KEY:?Generate one in Settings > Tools > Developer API}"
if [[ -z "${ANYTHINGLLM_URL:-}" ]]; then for candidate in "http://localhost:3001" "http://172.17.0.1:3001"; do if curl --silent --fail --max-time 2 "${candidate}/api/ping" >/dev/null 2>&1; then ANYTHINGLLM_URL="${candidate}" break fi donefi: "${ANYTHINGLLM_URL:?No AnythingLLM instance answered on port 3001}"
# "query" keeps the model inside the retrieved documents; "chat" would let it# answer from its own general knowledge, which is how you get invented articles.## The random sessionId matters more than it looks: without it every call lands# in the workspace's default thread, and the model reads its own previous# answers as context. One bad answer then repeats itself for every later# question, even after the underlying retrieval has been fixed.response="$(curl --silent --show-error \ --header "Authorization: Bearer ${ANYTHINGLLM_API_KEY}" \ --header "Content-Type: application/json" \ --request POST "${ANYTHINGLLM_URL}/api/v1/workspace/${WORKSPACE}/chat" \ --data "$(jq -nc --arg m "${question}" --arg s "cli-${RANDOM}${RANDOM}-$$" \ '{message: $m, mode: "query", sessionId: $s}')")"
error="$(jq -r '.error // empty' <<<"${response}")"if [[ -n "${error}" && "${error}" != "null" ]]; then printf 'AnythingLLM returned an error: %s\n' "${error}" >&2 exit 1fi
printf '\n\033[1;36m❓ %s\033[0m\n\n' "${question}"jq -r '.textResponse' <<<"${response}"
# OSC 8 hyperlinks make the title itself clickable in VS Code's terminal and# Windows Terminal; anywhere else (or when piped) fall back to the bare URL.if [[ -t 1 ]]; then print_source() { printf ' \033[1;32m•\033[0m \033]8;;%s\033\\\033[4m%s\033[0m\033]8;;\033\\\n' "${1}" "${2}" printf ' \033[2m%s\033[0m\n' "${3}" }else print_source() { printf ' • %s\n %s\n' "${2}" "${1}" }fi
sources="$(jq -r ' [ .sources[]? | select(.chunkSource // "" | startswith("link://")) | { title, url: (.chunkSource | sub("^link://"; "")) } ] | unique_by(.url) | .[] | "\(.url)\t\(.title)"' <<<"${response}")"
if [[ -n "${sources}" ]]; then printf '\n\033[1;33m📚 Sources the answer was built from\033[0m\n' while IFS=$'\t' read -r url title; do print_source "${url}" "${title}" "${url##*/}" done <<<"${sources}"else printf '\n\033[2mNo source document was cited.\033[0m\n'fi
# Vector search ranks by similarity and stops at topN, so it will never# enumerate exhaustively: a couple of long articles can fill every slot. This# second pass is the opposite trade-off — a dumb, exact, complete scan of the# frontmatter. Together they answer "where did I write about X" properly.blog_dir="${BLOG_DIR:-blog}"
# Function words, English and French — the vocabulary of asking a question# rather than of any topic. Rarity alone can't catch these: "content" and# "already" each legitimately appear in a handful of titles.stopwords="about after algo already also always another anything article articles beenbefore blog both content cover covers does each every find first from givehave here how into just know like list made make mention mentions more mostmust need only other post posts really related same search some somethingsuch talk talked than that their them then there these they this thosetopic use used using very want what when where which while will with writewritten wrote youralors aussi autre avec avoir beaucoup cela cette comme contenu dans dejadéjà donc dont elle encore est etre être fait faire ils leur mais mes monnous ont parle parler parlé pour quel quelle quelles quels qui quoi sanssont sujet sur tous tout toute une vous"
mapfile -t candidates < <(printf '%s' "${question}" | tr -c '[:alnum:]' '\n' | tr '[:upper:]' '[:lower:]' | awk 'length($0) >= 4' | sort -u | grep -vxF -f <(printf '%s' "${stopwords}" | tr -s '[:space:]' '\n' | grep .) || true)
# Second filter, dictionary-free: drop any surviving word that is simply too# common to be a topic. "docker" matches half the blog and would drown the# result; "joomla" matches nine posts and is exactly what you asked about.total="$(find "${blog_dir}" -type f \( -name 'index.md' -o -name 'index.mdx' \) | wc -l)"ceiling=$(( total / 10 ))[[ "${ceiling}" -ge 3 ]] || ceiling=3
keywords=()matched=""for word in "${candidates[@]}"; do files="$(grep -rliE "^(title|slug|description|mainTag):.*${word}|^ - ${word}$" \ "${blog_dir}" --include='index.md' --include='index.mdx' || true)" count="$(grep -c . <<<"${files}" || true)" [[ -n "${files}" && "${count}" -le "${ceiling}" ]] || continue keywords+=("${word}") matched+="${files}"$'\n'done
if [[ "${#keywords[@]}" -gt 0 ]]; then matches="$(sort -u <<<"${matched}" | grep . || true)" if [[ -n "${matches}" ]]; then printf '\n\033[1;33m🔎 Exact frontmatter matches (%s)\033[0m\n' "${keywords[*]}" while read -r file; do [[ -n "${file}" ]] || continue # sed, not awk -F': ' — plenty of titles contain a colon of their own. slug="$(sed -n 's/^slug: *//p' "${file}" | head -1 | sed 's/^"//; s/"$//')" title="$(sed -n 's/^title: *//p' "${file}" | head -1 | sed 's/^"//; s/"$//')" print_source "${SITE_URL:-https://www.avonture.be}/blog/${slug}" "${title}" "${slug}" done <<<"${matches}" fifiprintf '\n'Ce script interroge un workspace AnythingLLM pour répondre à une question sur des articles de blog. Il affiche la réponse du modèle ainsi que les sources citées en tant que liens cliquables, puis effectue une deuxième recherche en scannant directement les métadonnées des fichiers markdown pour trouver des correspondances exactes avec les mots-clés pertinents de la question.
Branchez votre shell dessus, en exportant la clé une fois :
export ANYTHINGLLM_API_KEY="your-key-here"
ai-blog-search() { (cd ~/repositories/blog && .scripts/anythingllm-search.sh "$@"); }
$ ai-blog-search Do I already have content about Joomla?

❓ Do I already have content about Joomla?

Yes, you have content about Joomla. Here are the articles related to Joomla:

1. **Create your Joomla website using Docker - Part 1** (published 2023-12-22)
   - URL: [https://www.avonture.be/blog/docker-joomla](https://www.avonture.be/blog/docker-joomla)

2. **Create your Joomla website using Docker - Part 2** (published 2024-10-18)
   - URL: [https://www.avonture.be/blog/docker-joomla-part-2](https://www.avonture.be/blog/docker-joomla-part-2)

3. **Joomla - Run a SQL statement outside Joomla and display a nice HTML table** (published 2024-06-02)
   - URL: [https://www.avonture.be/blog/joomla-show-table](https://www.avonture.be/blog/joomla-show-table)

These articles cover topics such as setting up a Joomla website using Docker and running SQL statements in Joomla.

📚 Sources the answer was built from
  • Create your Joomla website using Docker - Part 1 (published 2023-12-22)
    https://www.avonture.be/blog/docker-joomla
  • Create your Joomla website using Docker - Part 2 (published 2024-10-18)
    https://www.avonture.be/blog/docker-joomla-part-2
  • Organize Your Docusaurus Content with a Custom Series Component (published 2025-09-09)
    https://www.avonture.be/blog/docusaurus-series
  • Joomla - Run a SQL statement outside Joomla and display a nice HTML table (published 2024-06-02)
    https://www.avonture.be/blog/joomla-show-table

🔎 Exact frontmatter matches (joomla)
  • FrankenPHP, a modern application server for PHP
    https://www.avonture.be/blog/frankenphp-docker-joomla
  • Create your Joomla website using Docker - Part 1
    https://www.avonture.be/blog/docker-joomla
  • Update php.ini when using a Docker image
    https://www.avonture.be/blog/docker-php-ini
  • Joomla - delete tables from your database according to a certain prefix
    https://www.avonture.be/blog/joomla-db-kill-tables-prefix
  • Joomla - Run a SQL statement outside Joomla and display a nice HTML table
    https://www.avonture.be/blog/joomla-show-table
  • aeSecure - QuickScan - Free viruses scanner
    https://www.avonture.be/blog/aesecure-quickscan
  • Start Joomla with Docker in just a few clicks
    https://www.avonture.be/blog/docker-joomla-right-to-the-point
  • Create your Joomla website using Docker - Part 2
    https://www.avonture.be/blog/docker-joomla-part-2
  • Restore a Joomla backup using Docker
    https://www.avonture.be/blog/docker-joomla-restore-jpa
Deux décisions de conception là-dedans ont gagné leur place à la dure.
Un sessionId aléatoire à chaque appel. Sans ça, chaque requête atterrit dans le thread par défaut du workspace et le modèle lit ses propres réponses précédentes comme contexte. J'ai perdu un temps sincèrement embarrassant sur un workspace qui persistait à dire qu'il n'avait aucun article WordPress — longtemps après que la récupération avait été corrigée et renvoyait les bons chunks. Il se citait lui-même, depuis la tentative ratée précédente. Une commande de recherche n'a rien à faire avec un historique de conversation.
Deux listes de résultats au lieu d'une. Regardez l'exécution ci-dessus : la moitié sémantique nomme trois articles Joomla, la moitié grep en trouve neuf. Cet écart n'est pas un bug à corriger par réglage — la recherche vectorielle s'arrête au topN du workspace et classe par similarité, donc deux ou trois longs articles remplissent les places avec leurs propres chunks. Passer topN de 20 à 60 a ajouté exactement un résultat. Le script lance donc aussi un simple grep sur title/slug/description/tags. La recherche sémantique trouve ce que vous n'arriviez pas à formuler ; grep garantit que vous n'avez rien loupé. Afficher les deux est la réponse honnête.
Transformer une phrase en termes de grep demande une astuce qui vaut la peine d'être volée : après avoir écarté les mots-outils évidents, le script écarte aussi tout mot survivant qui correspond à plus de 10 % du blog. « Docker » enterrerait tout sous la moitié du corpus ; « joomla » correspond à neuf articles et c'est précisément ce que vous demandiez. La rareté fait le travail qu'aucune liste de stopwords ne peut faire, et elle se fiche de la langue dans laquelle vous avez demandé.
Le RAG n'est pas un index de recherche
C'est l'ajustement mental le plus important. « Quels articles mentionnent X » est une question pour grep ou la recherche du site — exacte, complète, instantanée. Le RAG gagne sa place sur l'autre type de question : celle sur chpwd en haut de cet article, où vous vous souvenez de l'idée mais pas d'un seul mot que vous avez réellement utilisé, ou là où la réponse est enterrée dans un PDF que grep ne peut pas lire du tout. Attendre une énumération exhaustive d'un classement par similarité, c'est attendre la mauvaise chose du bon outil.
La même chose sous forme de fonction zsh
Le script ci-dessus est la version portable — il tourne dans un devcontainer, en CI, dans un hook post-commit, partout où il y a bash et jq. Pour l'usage quotidien je préfère taper un mot, donc il existe aussi comme membre de la famille ai-* : déposez-le dans ~/.zsh/fns/, et il s'enregistre auprès du dispatcher ai exactement comme le font ai-review et ai-commit.
# ai-blog-search — ask your own blog a question and get the matching articles# back, as clickable links.## The odd one out in this series: it doesn't call Ollama directly. It queries an# AnythingLLM workspace, which owns the vector index and calls Ollama itself for# both the embeddings and the answer. So the guard clause below is the# AnythingLLM counterpart of _ollama_check rather than a reuse of it.
AI_COMMANDS[blog-search]="ai-blog-search — ask your blog a question (RAG over every published article)"AI_PARAMS[blog-search]="text"
# Where the blog repository lives, used only by the exact-match pass. Without# it you still get the semantic answer — just not the grep safety net.: "${AI_BLOG_DIR:=$HOME/repositories/blog}": "${AI_BLOG_SITE_URL:=https://www.avonture.be}": "${AI_BLOG_WORKSPACE:=blog}"
# _anythingllm_check — credentials and reachability guard._anythingllm_check() { if [[ -z "${ANYTHINGLLM_API_KEY:-}" ]]; then echo "ai-blog-search: ANYTHINGLLM_API_KEY is not set — generate one under Settings > Tools > Developer API" >&2 return 1 fi
local host="${ANYTHINGLLM_URL:-http://localhost:3001}" if ! curl --silent --max-time 2 "${host}/api/ping" >/dev/null 2>&1; then echo "ai-blog-search: cannot reach ${host} — is the AnythingLLM container running?" >&2 return 1 fi}
# _ai_blog_link <url> <title> — one source line, hyperlinked when the terminal# is one (OSC 8) and a plain URL when the output is being piped._ai_blog_link() { if [[ -t 1 ]]; then printf ' \e[1;32m•\e[0m \e]8;;%s\e\\\e[4m%s\e[0m\e]8;;\e\\\n' "$1" "$2" printf ' \e[2m%s\e[0m\n' "${1:t}" else printf ' • %s\n %s\n' "$2" "$1" fi}
# The alias at the bottom of this file survives in the running shell, so on a# re-source ("source ~/.zshrc") it would shadow the name below and the function# definition would die with "parse error near '()'". Drop it first.(( $+aliases[ai-blog-search] )) && unalias ai-blog-search
ai-blog-search() { local question="$*" if [[ -z "$question" ]]; then echo "usage: ai-blog-search <your question>" >&2 return 1 fi
_anythingllm_check || return 1
local host="${ANYTHINGLLM_URL:-http://localhost:3001}"
# "query" confines the model to the retrieved excerpts; "chat" would let it # answer from general knowledge and describe articles that don't exist. # # The random sessionId is not cosmetic: without one every call lands in the # workspace's default thread, the model reads its own previous answers as # context, and a single wrong answer repeats itself for every later question. local response response=$( jq -nc --arg m "$question" --arg s "zsh-${RANDOM}${RANDOM}-$$" \ '{message: $m, mode: "query", sessionId: $s}' \ | curl --silent --show-error --data-binary @- \ --header "Authorization: Bearer ${ANYTHINGLLM_API_KEY}" \ --header "Content-Type: application/json" \ "${host}/api/v1/workspace/${AI_BLOG_WORKSPACE}/chat" )
local error error=$(print -r -- "$response" | jq -r '.error // empty') if [[ -n "$error" ]]; then echo "ai-blog-search: ${error}" >&2 return 1 fi
printf '\n\e[1;36m❓ %s\e[0m\n\n' "$question" print -r -- "$response" | jq -r '.textResponse'
local sources sources=$(print -r -- "$response" | jq -r ' [ .sources[]? | select(.chunkSource // "" | startswith("link://")) | {title, url: (.chunkSource | sub("^link://"; ""))} ] | unique_by(.url) | .[] | "\(.url)\t\(.title)"')
if [[ -n "$sources" ]]; then printf '\n\e[1;33m📚 Sources the answer was built from\e[0m\n' local line for line in ${(f)sources}; do _ai_blog_link "${line%%$'\t'*}" "${line#*$'\t'}" done fi
_ai_blog_grep "$question"}
# "?" and "*" are glob characters in zsh, and a natural question ends in one.# Without this, "ai-blog-search which posts cover Joomla?" dies with "no matches# found" before the function is even called. Declared after the function, since# zsh refuses to define a function whose name is an existing alias.alias ai-blog-search='noglob ai-blog-search'
# _ai_blog_grep <question> — the exact half of the answer.## Vector search ranks by similarity and stops at the workspace's topN, so it# never enumerates: two long articles can fill every slot. This pass is the# opposite trade-off — dumb, exact and complete._ai_blog_grep() { [[ -d "${AI_BLOG_DIR}" ]] || return 0
local question="$1"
# Function words, English and French: the vocabulary of asking a question # rather than of any topic. Rarity alone can't catch these — "content" and # "already" each legitimately appear in a handful of titles. local stopwords="about after already also always another anything article articles been before blog both content cover covers does each every find first from give have here into just know like list made make mention mentions more most must need only other post posts really related same search some something such talk talked than that their them then there these they this those topic used using very want what when where which while will with write written wrote your alors aussi autre avec avoir beaucoup cela cette comme contenu dans deja donc dont elle encore est etre fait faire ils leur mais mes mon nous ont parle parler pour quel quelle quelles quels qui quoi sans sont sujet sur tous tout toute une vous"
local -a candidates candidates=(${(u)${(s: :)${(L)question//[^[:alnum:]]/ }}})
# Second filter, dictionary-free: drop any surviving word too common to be a # topic. "docker" matches half the blog; "joomla" matches nine posts. local total ceiling total=$(find "${AI_BLOG_DIR}/blog" -type f \( -name 'index.md' -o -name 'index.mdx' \) | wc -l) ceiling=$(( total / 10 )) (( ceiling >= 3 )) || ceiling=3
local -a keywords matched local word files count for word in $candidates; do (( ${#word} >= 4 )) || continue [[ " ${stopwords} " == *" ${word} "* ]] && continue
files=$(grep -rliE "^(title|slug|description|mainTag):.*${word}|^ - ${word}\$" \ "${AI_BLOG_DIR}/blog" --include='index.md' --include='index.mdx' 2>/dev/null) [[ -n "$files" ]] || continue
count=$(print -r -- "$files" | grep -c .) (( count <= ceiling )) || continue
keywords+=("$word") matched+=(${(f)files}) done
(( ${#keywords} > 0 )) || return 0
printf '\n\e[1;33m🔎 Exact frontmatter matches (%s)\e[0m\n' "${keywords[*]}"
local file slug title for file in ${(u)matched}; do # sed, not awk -F': ' — plenty of titles contain a colon of their own. slug=$(sed -n 's/^slug: *//p' "$file" | head -1 | sed 's/^"//; s/"$//') title=$(sed -n 's/^title: *//p' "$file" | head -1 | sed 's/^"//; s/"$//') _ai_blog_link "${AI_BLOG_SITE_URL}/blog/${slug}" "$title" done printf '\n'}Ce script bash implémente une commande shell ai-blog-search qui pose une question à ton blog via AnythingLLM, un système qui utilise la recherche vectorielle pour trouver les articles pertinents. Il affiche d'abord la réponse générée par le modèle, puis liste les articles sources utilisés, et enfin effectue une recherche exacte dans les métadonnées du blog comme filet de sécurité supplémentaire.
Enregistrez-le sous ~/.zsh/fns/ai-blog-search.zsh, à côté du _ollama.zsh partagé par la série, qui déclare le registre AI_COMMANDS auquel ce fichier s'ajoute. Les deux, ainsi que les trois lignes de ~/.zshrc qui chargent le dossier, sont dans les étapes d'installation d'ai-test. Ouvrez ensuite un nouveau terminal, et ai-blog-search est prêt.
Voici un exemple d'utilisation :
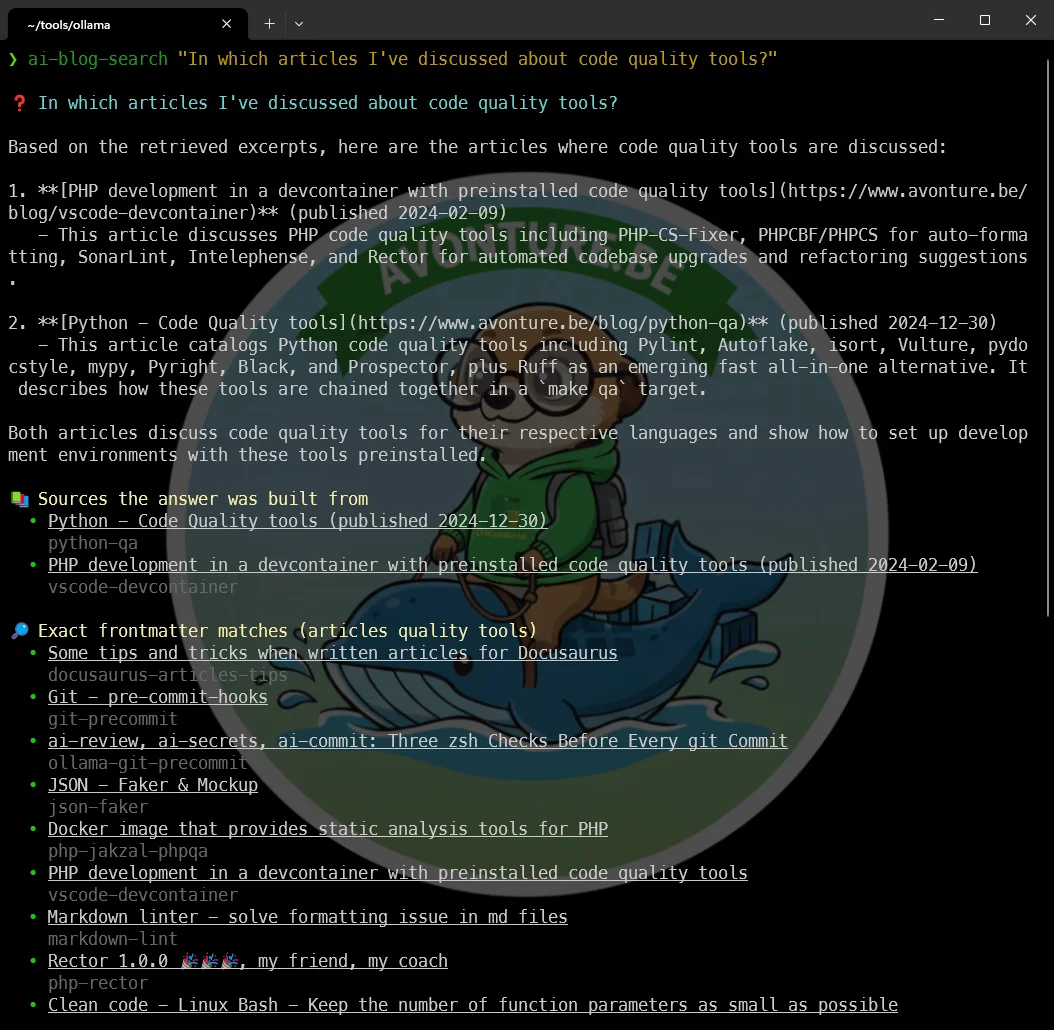
C'est l'intrus de cette série, et ça vaut la peine de dire pourquoi : toutes les autres fonctions ai-* appellent _ollama_query, alors que celle-ci parle à AnythingLLM — qui possède l'index vectoriel et appelle Ollama lui-même, pour les embeddings et pour la réponse. Elle apporte donc son propre garde-fou _anythingllm_check plutôt que de réutiliser _ollama_check, et déclare AI_PARAMS[blog-search]="text" pour que le menu ai demande la question avant de l'exécuter.
Le détail zsh qui vous coûte un après-midi
? et * sont des caractères de glob, et une question naturelle se termine par l'un des deux. Sans l'alias ai-blog-search='noglob ai-blog-search' en bas de ce fichier, ai-blog-search which posts cover Joomla? meurt avec zsh: no matches found avant même d'entrer dans la fonction. L'alias doit aussi venir après la définition de la fonction — zsh développe les alias au moment du parsing, donc il refuse de définir une fonction dont le nom est déjà un alias. Et comme cet alias survit ensuite dans votre shell, le fichier le supprime à nouveau à l'entrée ((( $+aliases[ai-blog-search] )) && unalias ai-blog-search) ; sans ce garde-fou, le fichier marche une fois puis casse chaque source ~/.zshrc suivant avec parse error near '()'.
Deux implémentations d'une même idée, c'est un vrai coût, alors soyez délibéré : le script bash est l'outil du repo et la seule source de vérité pour la logique ; la fonction zsh est le véhicule du quotidien, et reste autonome parce que toute la promesse de cette série est « déposez le fichier et ça marche ». Si vous n'interrogez jamais que depuis le repository du blog, prenez la version bash et sautez entièrement cette section.
À ce stade, tout — les documents eux-mêmes, leurs embeddings, les fichiers LanceDB — vit dans le volume anythingllm_storage, sur le PC de la maison. Très bien pour cette machine. Pas bien du tout pour ce qui suit.
Partie 2 — Documents sur une machine, GPU sur une autre
Voici la contrainte qui change tout : ma vraie documentation — ce qui est sous ~/repositories — vit sur mon PC de travail, et elle y reste. Pas synchronisée, pas copiée, pas uploadée ailleurs par confort.
Ça écarte l'option la plus simple, qui serait « il suffit d'ouvrir http://192.168.0.218:3001 depuis le navigateur de mon PC de travail et d'uploader les fichiers là ». Techniquement ça marcherait — mais uploader un fichier sur cette page envoie son contenu par le réseau vers le container du PC de la maison, où AnythingLLM stocke le texte parsé, les embeddings vectoriels et une copie en cache, à l'intérieur d'anythingllm_storage, sur un disque qui n'est pas le mien au bureau. C'est exactement le genre de copie que j'ai exclu. Le navigateur n'est que la fenêtre ; les documents eux-mêmes atterrissent là où le serveur derrière cette page tourne réellement.
La solution découle donc directement de là : faire tourner le serveur AnythingLLM lui-même sur le PC de travail — même container Docker, même compose.yaml — et ne solliciter le PC de la maison que pour la seule chose qui ne touche pas au contenu des documents : le modèle qui fait le vrai travail de réflexion.
Work PC (Docker)                          Home PC
┌─────────────────────────┐               ┌──────────────────────┐
│ anythingllm container   │  inference    │ ollama container     │
│  - documents            │ ────────────► │  - qwen2.5:14b       │
│  - vectors (LanceDB)    │ ◄──────────── │  - mxbai-embed-large │
│  - STORAGE_DIR          │   tokens back │  - 24GB VRAM         │
└─────────────────────────┘               └──────────────────────┘
Seuls les prompts et les chunks de texte récupérés nécessaires pour y répondre traversent le réseau pour cette unique requête — rien n'est stocké de l'autre côté.
Ce qui change réellement dans le fichier compose
Rien de structurel — c'est exactement le même compose.yaml que dans la partie 1, qui tourne via Docker Desktop sur le PC de travail à la place. La seule chose qui change, c'est l'adresse vers laquelle pointent OLLAMA_BASE_PATH et EMBEDDING_BASE_PATH, et cette adresse dépend de l'endroit où se trouve physiquement le PC de travail :
      - OLLAMA_BASE_PATH=http://192.168.0.218:11434      # same LAN, e.g. working from home
      - EMBEDDING_BASE_PATH=http://192.168.0.218:11434
Quand le PC de travail est sur le même réseau domestique, c'est tout — 192.168.0.218 est joignable exactement comme dans l'article précédent, et le reste de cette installation est un copier-coller de la partie 1.
Et quand il n'est pas à la maison
Cinq jours par semaine, ce PC de travail n'est pas du tout sur le LAN de la maison. Une simple adresse IP dans une plage privée 192.168.x.x n'est tout bonnement pas joignable depuis le bureau — c'est tout l'intérêt d'un réseau privé.
La solution pratique : un VPN maillé
Des outils comme Tailscale ou WireGuard donnent à chaque appareil — PC de la maison inclus — une adresse stable qui reste joignable quel que soit le réseau sur lequel il se trouve, sans ouvrir de ports sur votre routeur domestique vers Internet. Installez-le sur le PC de la maison, installez-le sur le PC de travail, et le même schéma OLLAMA_BASE_PATH ci-dessus continue de fonctionner — simplement avec l'adresse attribuée par le VPN au lieu de 192.168.0.218. Cette configuration mérite son propre article plutôt qu'un paragraphe expédié ici, alors considérez ceci comme une bande-annonce.
Ollama n'a aucune authentification propre
Exposer 192.168.0.218:11434 à l'intérieur d'un LAN privé est une chose ; le rendre joignable de n'importe où via un VPN est un cran d'exposition supplémentaire. L'API d'Ollama ne demande pas de mot de passe — quiconque peut atteindre ce port peut interroger vos modèles. Un VPN maillé comme Tailscale limite cette surface aux appareils que vous avez explicitement autorisés, et c'est précisément pour ça que c'est la réponse recommandée ici plutôt qu'une redirection de port sur le routeur.
Recréer les workspaces, cette fois pour de bon
Le container tournant maintenant sur le PC de travail, refaites l'onboarding de la partie 1 — même LLM provider, même modèle d'embedding, pointant vers l'adresse qui atteint actuellement le PC de la maison. Puis commencez à créer un workspace par repository sous ~/repositories, en alimentant chacun avec sa propre documentation.
Cette fois, les documents ne quittent jamais la machine devant laquelle vous êtes assis. La seule chose qui fait l'aller-retour vers le PC de la maison, c'est une question et la poignée de chunks de texte nécessaires pour y répondre — exactement la répartition que je voulais au départ.
Sous le capot (sautez si vous voulez juste l'utiliser)
Tout ce qui précède suffit pour faire tourner ça. Ce qui suit est le seul morceau des entrailles d'AnythingLLM qui vaille la peine d'être connu, parce qu'il explique pourquoi le script d'indexation fait quelque chose qui paraît sinon arbitraire.
D'où vient cette mauvaise date
Trois champs, et seulement trois, atteignent le modèle. Quoi qu'ait accepté l'API au moment de l'upload, AnythingLLM construit cet en-tête et le préfixe à chaque chunk :
<document_metadata>
sourceDocument: Tabnine - AI Autocomplete & Chat for Javascript, Python, ... (published 2024-03-02)
published: 8/10/2026, 9:56:01 AM
source: https://www.avonture.be/blog/vscode-tabnine
</document_metadata>
published vient du collector : published: createdDate(fullFilePath), obtenu par un stat sur le fichier temporaire qu'il vient de recevoir. Pas la date de votre frontmatter — le jour où vous avez lancé l'indexeur. Et metadata.published est silencieusement ignoré à l'upload, donc il n'y a aucun moyen de le corriger.
Il ne reste donc exactement que deux leviers, et c'est pourquoi le script actionne les deux : le titre porte la vraie date ajoutée sous la forme (published YYYY-MM-DD), et chunkSource porte l'URL réelle parce qu'un préfixe link:// est la seule chose qui se transforme en ligne source:. Tout le reste de ce que vous passez à l'upload — docSource, description, docAuthor — est stocké, récupérable via l'API, et jamais montré au modèle.
C'est aussi pourquoi le system prompt n'est pas une décoration optionnelle. Deux dates contradictoires se trouvent dans cet en-tête sur chaque chunk, et rien dans les données ne dit laquelle croire.
Points clés à retenir
La seule chose à retenir en prose : les documents vivent là où tourne le container, pas là où se trouve le navigateur. Tout le reste de cette page en découle — où le déployer, pourquoi il n'y a pas de case « indexer ce dossier », et pourquoi la voie de masse est l'API plutôt que l'interface graphique.
Le reste est de la matière à consulter, et voici les valeurs qui m'ont coûté un après-midi chacune :
Réglages qui cassent tout silencieusement quand ils sont faux
EMBEDDING_MODEL_MAX_CHUNK_LENGTH=400— doit rester sous le contexte de l'embedder (ollama show <model>; 512 pourmxbai-embed-large). Au-dessus, tous les embeddings échouent et le workspace reste vide sans aucune erreur dans l'interfaceOLLAMA_EMBEDDING_BATCH_SIZE=16— pure vitesse ; la valeur par défaut de 1 envoie un chunk par appel HTTPtopN= 20, dans Workspace Settings → Vector Database — la valeur par défaut de 4 répond aux questions portant sur tout le corpus à partir d'un seul article. Au-delà d'environ 20, ça n'apporte presque rien- System prompt du workspace — pas optionnel : c'est lui qui tranche entre les deux dates contradictoires présentes dans chaque en-tête de chunk, et qui corrige le formatage des dates une fois pour toutes
"mode": "query"dans chaque appel API —"chat"laisse le modèle répondre depuis ses connaissances générales et inventer des articles que vous n'avez jamais écrits- Un
sessionIdneuf à chaque appel — sans ça, le modèle lit ses propres réponses précédentes, et une mauvaise réponse se répète à l'infini ANYTHINGLLM_API_KEY(Settings → Tools → Developer API), plusAI_BLOG_DIRetAI_BLOG_SITE_URLpour la fonction zsh
Conclusion
Ce qui a commencé par « je n'arrive jamais à retrouver cette config que j'ai notée quelque part » s'est transformé en une quantité vraiment modeste de travail Docker : un compose.yaml, pointé vers un modèle que je faisais déjà tourner pour autre chose. Ce qui vaut la peine d'être retenu, ce n'est pas le YAML — c'est la prise de conscience qu'un bouton « upload » d'interface web est une requête vers l'endroit où vit son serveur, et c'est exactement le détail qui décide si vos documents restent en place ou migrent discrètement vers une machine que vous n'aviez pas prévue. Une fois ça compris, l'installation sur deux machines n'était pas un compromis ; c'était juste la forme évidente dès lors que le GPU et les documents ne vivent pas au même endroit. Maintenant, chaque fois que je me surprends à vouloir faire grep -r en espérant, j'interroge le workspace à la place.
La leçon inconfortable, c'est l'autre : une stack RAG ne peut pas vous dire qu'elle est cassée. La mienne a indexé 248 articles sans une seule erreur, puis a nié avoir quoi que ce soit sur WordPress. Si vous ne retenez qu'une habitude de cet article, retenez le test de cosinus de trente secondes avant de faire confiance à un embedder — et si vous voulez que votre terminal réponde davantage à vos questions en local, la famille ai-review, ai-secrets et ai-commit est d'où vient celle-ci. Le VPN maillé qui fait fonctionner l'installation sur deux machines depuis le bureau, c'est l'article que je vous dois ensuite.
Cet article fait partie de la série Ollama au quotidien :
- Installer Ollama et obtenir une IA locale
- Accéder à Ollama depuis votre réseau local
- ai-test : générer les tests unitaires manquants depuis votre terminal avec un LLM local
- ai-review, ai-secrets, ai-commit : trois vérifications zsh avant chaque git commit
- AnythingLLM : discuter avec toute votre documentation éparpillée
- ai-translate & ai-summarize : des documents confidentiels, traités 100 % en local
- ai-diagram : d'une phrase (ou d'un compose.yaml) à un diagramme Mermaid
- ai-data : laissez un LLM local écrire vos one-liners jq et awk
- ai-explain : l'ELI5 des scripts et des erreurs, directement dans votre terminal
Chargement des commentaires…