Claude Code - Des slash commands à un workflow en couches
Comment le dossier .claude/ de ce blog est passé d'une poignée de slash commands à un ensemble de commands, hooks, skills, agents et rules qui travaillent ensemble — un parcours d'apprentissage concret, et les cas où un script déterministe bat une question posée à l'IA.


Traduction automatique
Cet article fait partie de la série Claude Code :
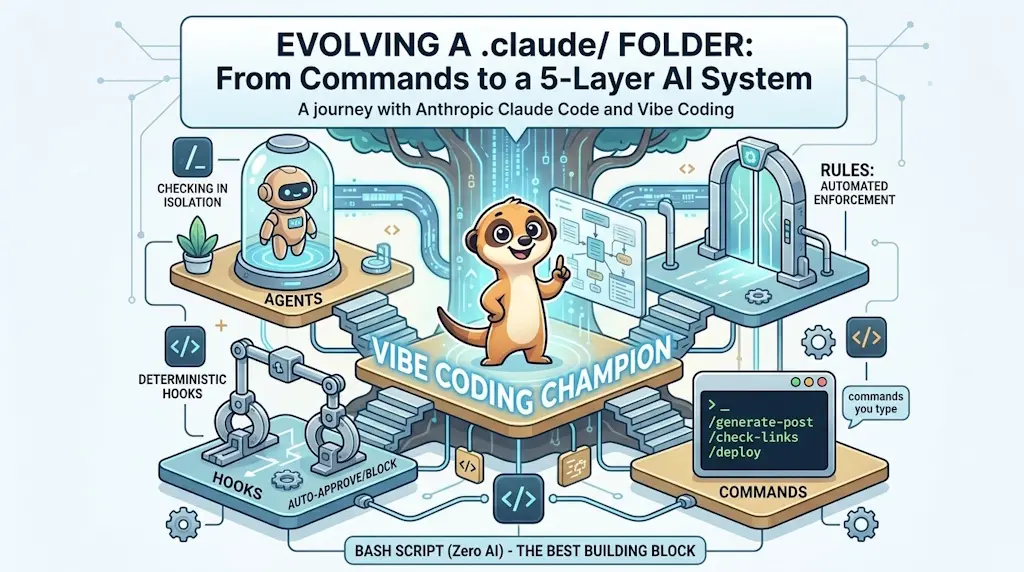
Le dossier .claude/ de ce blog est passé, en quelques mois, d'une poignée de slash commands à un
système à cinq couches : des commands que vous tapez, des hooks qui bloquent ou approuvent
automatiquement de façon déterministe, des skills qui encodent ce que « bon » veut dire, des agents
qui le vérifient dans un contexte isolé, et des rules qui imposent la version courte
automatiquement. Cet article suit l'ordre dans lequel tout a réellement été construit, à quoi sert
chaque couche, un exemple réel de chacune, et pourquoi un simple script Bash — sans la moindre IA —
est parfois la meilleure brique possible.
Comme tout débutant, mes premières sessions Claude Code sur ce blog commençaient toutes de la même façon, jour après jour : je réexpliquais, dans le chat, à quoi ressemble un bon script Bash ici, ce qu'un Dockerfile ne doit jamais faire, ou comment numéroter un nouveau fichier TODO sans entrer en collision avec un existant. Claude faisait le travail, mais c'était moi qui portais le règlement — retapé, session après session.
Mon dossier .claude/ ne ressemble plus du tout à ce qu'il était. Aujourd'hui, il contient 15 slash
commands, 4 agents reviewers en lecture seule, 10 skills, 3 rules toujours actives, et quelques
scripts Bash qui ne touchent jamais à l'IA. Rien n'est arrivé d'un coup — chaque couche est apparue
pour résoudre un problème que la précédente ne savait pas traiter.
À quoi ressemblent ces cinq couches en pratique
Cinq ingrédients rendent tout cela possible, et chacun a sa propre section plus bas — voici juste la version courte, pour que la démo qui suit ne ressemble pas à une soupe d'acronymes :
Cinq mots à garder en tête
- Command — ce que vous tapez vous-même (
/quelquechose). - Skill — une checklist que Claude lit de lui-même, sans qu'on la lui demande.
- Agent — exécute cette checklist dans sa propre fenêtre séparée et restreinte, loin de votre conversation principale.
- Rule — se charge automatiquement dès qu'un fichier correspondant est ouvert.
- Hook — peut bloquer une action net, sans négociation possible.
Deux de ces cinq n'attendent jamais un humain : une rule se charge à l'instant où un fichier correspondant s'ouvre, et un hook se déclenche à chaque appel d'outil correspondant — rien à taper, et Claude n'a pas voix au chapitre. Les trois autres se déclenchent à la main, et s'enchaînent comme le montre la démo ci-dessous : vous tapez une command, la command appelle un agent, et l'agent applique une skill pour rendre le verdict — sachant, comme expliqué plus loin, qu'une skill peut aussi se charger toute seule quand sa description colle à la tâche en cours, sans aucune command dans la boucle.
Voici à quoi ressemble aujourd'hui une lecture critique d'un article de blog, une fois les cinq couches en place, avant même sa publication :
/review:reader git-precommit
On n'a plus besoin de réexpliquer à Claude ce que « bon » veut dire pour un article de ce blog — la
skill reader-first-docs le détaille déjà, et /review:reader l'applique directement : quelle part
de l'article se trouve entre <!-- truncate --> et la première vraie preuve — une sortie de
commande réelle, pas seulement une étape d'installation ?
git-precommit— sortie réelle dix lignes après<!-- truncate -->, soit environ 7 % du corps de l'article. Largement sous le seuil vert de 15 %, rien d'installé ni d'expliqué avant. Verdict : OK, rien à restructurer.
Cette checklist — mettre la valeur en avant, marquer les approfondissements comme optionnels, garder l'installation hors de la première moitié — n'a jamais eu à être retapée, des mois après avoir été écrite une première fois.
Et un détail à souligner avant tout le reste : toutes les commands de ce workflow ne reposent pas
sur Claude. /todos:add, la command qui ajoute une nouvelle entrée au backlog, a d'abord besoin du
prochain ID libre — un pur problème de comptage. Plutôt que de demander au modèle de parcourir
.todos/ et de compter, elle appelle un simple script :
$ .claude/scripts/todo_next_id.sh .todos
0105
Bonne pratique : un script vaut mieux qu'un prompt
Dès qu'une étape relève de la pure logique — compter des fichiers, incrémenter un ID, parser une date, vérifier un verrou — écrivez-la comme un simple script et faites-le appeler par la command. C'est déterministe (la même entrée donne toujours la même sortie), ça coûte zéro token, et ça se teste tout seul, sans modèle dans la boucle. Gardez l'IA pour les étapes qui demandent vraiment du jugement.
Pourquoi une organisation en couches fonctionne
- Une seule couche se tape. Les slash commands sont le seul élément auto-découvrable — l'autocomplétion les trouve. Skills, rules, agents et hooks restent invisibles jusqu'à ce que quelque chose les déclenche ; ils façonnent la manière dont Claude travaille sans alourdir ce que vous devez penser à invoquer.
- Chaque couche répond à une question différente. Une skill décide ce que « bon » veut dire. Un agent décide qui le vérifie, et dans quel isolement. Une rule décide quand la version courte s'applique automatiquement. Un hook décide ce qui est tout simplement interdit — aucun jugement, aucune façon de faire changer le modèle d'avis.
- Les agents en lecture seule gardent le bruit de review hors de la conversation qui compte.
C'est une économie de tokens qui vient de l'architecture, pas de la discipline de prompting — un
bon complément aux astuces de gestion de session de une
précédente série de conseils pour économiser des tokens, centrée sur
/clear,/compactet la taille deCLAUDE.md. - Une rule n'est volontairement pas une explication complète. C'est un extrait compressé DO/DON'T de la skill sœur, chargé uniquement quand un fichier correspondant est réellement ouvert — le raisonnement complet reste à un clic, pas dans chaque fenêtre de contexte.
- La couche la moins chère de toutes n'appelle pas le modèle. Un simple script, comme ci-dessus, est le socle sur lequel tout le reste se construit.
Commencez ici : votre première slash command
Les slash commands ont été le point d'entrée facile, et elles le restent — un fichier Markdown avec
un petit en-tête frontmatter, détecté automatiquement dès qu'il atterrit dans .claude/commands/.
Par exemple, créez simplement le fichier .claude/commands/pr-description.md dans votre projet avec
ce contenu :
---description: Draft a pull-request description from the current branch's diff against mainargument-hint: "[base-branch] (optional — defaults to main)"allowed-tools: Bash(git diff*), Bash(git log*), Read---
# PR description
Look at `git diff $ARGUMENTS...HEAD` and `git log $ARGUMENTS...HEAD --oneline`. Draft a pull-request description: a one-paragraph summary of the "why", then a bulleted "what changed". Do not include a test plan unless the diff touches test files.Ce script génère automatiquement une description de pull-request en analysant les différences et l'historique Git entre une branche de base (main par défaut) et la branche actuelle. Il produit un résumé en un paragraphe expliquant la raison des changements, suivi d'une liste à puces détaillant ce qui a changé, en omettant le plan de test sauf si des fichiers de test sont modifiés.
Tapez maintenant /pr-description dans une session Claude Code, et ce prompt s'exécute avec le diff
courant déjà sous les yeux — rien à retenir, rien à réexpliquer. Deux détails du fichier ci-dessus
comptent plus qu'ils n'y paraissent :
argument-hintest ce que l'autocomplétion affiche avant même que vous ayez fini de taper la command — de la documentation à bas prix pour votre futur vous.allowed-toolslimite le rayon d'action avant que la command ne s'exécute. Celle-ci peut lire l'historique Git et des fichiers, et rien d'autre — elle ne peut rien modifier, même par erreur.
Trois commands réelles issues du dossier .claude/commands/ de ce blog montrent la même forme à
différentes tailles. /review:bash est à peine plus qu'un pointeur vers l'agent traité plus loin
dans cet article :
---description: Audit this project's Bash scripts against the bash-best-practices skill (read-only)argument-hint: "[path] (optional — defaults to the whole project)"allowed-tools: Agent---
# Bash review
Invoke the `bash-best-practices-reviewer` agent to audit **$ARGUMENTS** (or the wholeproject if no argument is given) against the `bash-best-practices` skill, and againstthis project's own bash-conventions rule/skill too, if it ships one.
Read-only: the agent reports violations with file:line, it never edits.This is a documentation file that describes a code review tool for Bash scripts. It explains that the tool will check Bash files against best-practice standards and any custom rules the project defines, and will only report problems without making any changes.
/links maintient la convention de maillage interne de ce blog — 2 à 4 liens inline par article,
plus un lien réciproque dans l'article plus ancien vers lequel il pointe :
Et /todos:add est la command derrière le script todo_next_id.sh vu plus haut — sa ligne
allowed-tools nomme explicitement le script, si bien que la command peut l'appeler mais rien
d'autre :
Tracer une limite infranchissable : les hooks
Le prompt d'une slash command reste une instruction que Claude lit et dont il peut, dans une session
suffisamment longue, discrètement s'écarter — comme une personne oublie une consigne donnée une
heure et de nombreux messages plus tôt. Un hook fonctionne autrement : c'est une commande shell
que le harness Claude Code (le programme qui exécute la session, distinct de Claude lui-même) lance
automatiquement à un point fixe — avant que Claude lise un fichier ou exécute une commande (ce que
Claude Code appelle un tool call), juste après, ou à la fin de la session — et son code de sortie
décide de la suite. Claude n'a aucun mot à dire dans cette décision. C'est la même idée qu'un hook
Git pre-commit dans un article précédent, une couche plus
bas : celui-là intercepte un commit, celui-ci intercepte un seul tool call.
Le fichier .claude/settings.json de ce blog n'en contient encore aucun — il ne porte qu'une liste
permissions.allow. Les hooks ont gagné leur place sur un autre projet, en Python, qui lance ruff
et pytest en permanence pendant une session. Réduit à la mécanique de base :
{ "permissions": { "deny": ["Read(./.env)", "Read(./**/*.key)", "Read(./secrets/**)"] }, "hooks": { "PreToolUse": [ { "matcher": "Bash", "hooks": [ { "type": "command", "command": "cmd=$(jq -r '.tool_input.command'); if [[ \"$cmd\" == pytest* ]]; then echo '{\"hookSpecificOutput\":{\"hookEventName\":\"PreToolUse\",\"permissionDecision\":\"allow\"}}'; fi" } ] } ], "PostToolUse": [ { "matcher": "Write|Edit", "hooks": [ { "type": "command", "command": "f=$(jq -r '.tool_input.file_path'); if [[ \"$f\" == *.py ]]; then ruff check \"$f\"; fi" } ] } ], "Stop": [ { "hooks": [{ "type": "command", "command": "pytest -q" }] } ] }}Ce fichier de configuration définit des règles de sécurité et d'automatisation pour contrôler l'accès aux fichiers sensibles et exécuter des vérifications de code. Il interdit la lecture de fichiers d'environnement et de clés, puis automatise les tests et vérifications de style lors de l'utilisation d'outils spécifiques.
Quatre idées à reprendre, quel que soit le langage du projet :
permissions.denybloque netReadsur les secrets — un hook n'est même pas sollicité, le tool call n'a jamais lieu.PreToolUseapprouve ici automatiquementpytesten particulier, pour qu'une session longue et soignée ne s'arrête pas sur une demande de confirmation chaque fois que la suite de tests tourne.PostToolUseréagit dès qu'un fichier Python est écrit ou modifié : il lanceruff checksur ce seul fichier, immédiatement, au lieu d'attendre que le lecteur — ou un job de CI — s'en aperçoive plus tard.Stopse déclenche une fois, quand Claude considère une tâche terminée et s'apprête à rendre la main — le dernier point de contrôle, pas un par édition. Ici, il relance toute la suite de tests ; sipytestéchoue, le code de sortie non nul du hook indique à Claude que son tour n'est pas vraiment fini, et pourquoi. C'est le seul hook capable de contredire un « j'ai terminé ».
Un hook est un plancher, pas un substitut
Un hook ne se déclenche que sur la forme de tool call à laquelle il est associé — il ne comprend pas l'intention comme le fait un modèle qui suit une skill. Réservez-le à la poignée de règles qui ne doivent jamais être négociables (secrets, lint ou tests obligatoires) ; laissez tout ce qui demande du jugement à une skill.
Encoder vos standards : les skills, vérifiés par des agents
Une skill est l'endroit où « du bon Bash » ou « un bon Dockerfile » est réellement écrit — une
fois, comme source unique de vérité, au lieu d'être retapé dans le chat à chaque session. Voici la
vraie skill bash-best-practices de ce blog, en intégralité — elle commence par un champ
description et un flag disable-model-invocation, puis les conventions elles-mêmes :
Le champ description a un double rôle : c'est ce qu'un humain lit pour savoir ce que couvre la
skill, et c'est ce que Claude compare à la tâche courante pour décider de la charger sans qu'on le
lui demande. Un flag contrôle cela : disable-model-invocation: false garde le chargement
automatique actif ; passez-le à true et la skill ne se charge que si une command l'appelle
explicitement.
Une skill seule n'est qu'une mémoire plus stricte. Ce qui l'a transformée en véritable audit, c'est un agent assorti — un sous-agent avec un nom, un jeu d'outils fixe et étroit, et une seule mission :
Deux choix de conception pèsent plus lourd que la longueur du fichier ne le suggère :
tools: Read, Grep, Glob, Bash— pas d'Edit, pas deWrite. Cet agent ne peut physiquement pas modifier un fichier, ce qui veut dire qu'une review ne peut jamais dériver accidentellement en réécriture, et qu'une chaîne hostile enfouie dans un fichier relu ne peut pas l'y pousser non plus.- Un agent n'est accessible qu'à travers une slash command correspondante —
/review:bashest la seule porte d'entrée. Il n'y a aucune entrée d'autocomplétion pour l'agent lui-même ; la découvrabilité vit entièrement dans la couche command, la logique de review entièrement dans la couche agent.
Le même motif se répète pour python-best-practices (couplée à python-best-practices-reviewer,
surtout utile sur les points que ruff et mypy n'attrapent pas
déjà) et pour dockerfile-best-practices. Une skill, un agent étroit, une command — une
forme qui passe à l'échelle pour n'importe quel langage ajouté ensuite.
Un cas concret : le contrôle de Time-to-Value de ce blog
Tous les couplages vus jusqu'ici relisent du code. Sur ce blog, avant de publier un article, je
lance /review:reader — il charge la skill reader-first-docs et vérifie la structure du post. L'un
des critères mesurés est le Time-to-Value : dans les 30 premières secondes de lecture environ, un
lecteur doit déjà comprendre ce que couvre l'article et s'il vaut la peine de continuer. Un score
TTV élevé signifie l'inverse — le lecteur a dû traverser trop de texte avant d'arriver au moment
« ah, voilà de quoi parle l'article ». Voici la skill en intégralité :
La métrique centrale, le Time-to-Value, est mécanique, pas une impression : on trouve T, la ligne
de <!-- truncate --> ; on trouve la première vraie preuve après elle — une sortie de commande
réelle, jamais une simple étape d'installation ; on calcule TTV = (proof_line − T) / BODY, où
BODY est tout ce qui suit T. C'est exactement le calcul derrière la démo d'ouverture : sur
l'article sur le pre-commit, la sortie réelle arrive dix
lignes après <!-- truncate -->, BODY fait 148 lignes, donc TTV ≈ 7 % — largement sous le seuil
vert de 15 % défini par la skill elle-même.
Trois paliers transforment ce pourcentage en verdict : 🟢 OK sous 15 %, 🟠 MINOR sous 30 % (une
note de journal, jamais un TODO, et c'est voulu — sinon un passage sur 40 articles enterrerait les
vraies trouvailles sous des one-liners pour chaque post à la conclusion simplement plate), 🔴
RESTRUCTURE à 30 % ou plus, le seul palier qui crée un TODO.
Toutes les skills ne vont pas de pair avec un agent
/review:reader ne délègue pas à un agent isolé comme le fait /review:bash — il a besoin d'un
accès Write pour journaliser l'avancement d'un lot entier dans
.todos/0000-reader-review-journal.md, donc il tourne inline, même skill, sans couche d'isolement.
Un agent reader-first-docs-reviewer existe bien dans ce projet, mais il audite un autre périmètre
(de la documentation longue comme un README, pas des articles de blog) et n'est encore relié à
aucune command. La forme décrite dans la section précédente est courante, pas universelle.
Toujours actives, sans invocation : les rules
Les skills et les agents attendent tous les deux un déclencheur — une tâche qui correspond, ou une
command tapée. Une rule n'attend rien : elle se charge à l'instant où un fichier correspondant
est ouvert ou modifié, par glob sur paths, sans aucune invocation.
Voici le vrai fichier — sa première ligne renvoie déjà vers l'endroit où vit réellement le raisonnement :
---paths: - "**/*.sh" - "**/*.bash" - "**/.bash_aliases"---
# Bash — always apply
Full rationale and more patterns: `bash-best-practices` skill. Verify: `shellcheck`/`shfmt`.
- ✅ DO: `set -o nounset` + `set -o errexit` (+ `pipefail` if the project relies on failing mid-pipe) at the top of every executable script.- ✅ DO: quote every variable expansion — `"${var}"`, `"${arr[@]}"` for arrays. ❌ DON'T: `rm $file` / `for f in $files` — unquoted, splits on whitespace and globs.- ✅ DO: `result=$(command)`. ❌ DON'T: `` result=`command` `` (deprecated backticks).- ✅ DO: `if [[ -f "${file}" ]]`. ❌ DON'T: `if [ -f ${file} ]` (unquoted, `[` not `[[`).- ✅ DO: propagate errors explicitly — `cmd || { echo "failed" >&2; return 1; }`. ❌ DON'T: `result=$(cmd) || echo "Error"` — swallows the failure, doesn't return/exit.- ✅ DO: check exit status immediately — `if command; then`. Only defer to `$?` with an inline `# shellcheck disable=SC2181` justification.- ✅ DO: a `grep` inside a `set -o pipefail` script that can legitimately match nothing ends with `|| true` — otherwise its exit 1 aborts the script.This is a markdown style guide for bash shell scripts that defines which files it applies to (shell scripts with .sh, .bash, or .bash_aliases extensions) and then lists best practices for writing safe, reliable bash code. It covers error handling, variable quoting, command substitution syntax, and conditional statements — all things that prevent common bash pitfalls like word-splitting bugs or silently ignored errors.
Une rule ne répète pas le raisonnement de la skill, elle en extrait les paires DO/DON'T brutes dont
un modèle a besoin en pleine édition, et renvoie vers le pourquoi. La même forme couvre le
Markdown, en gardant le gras en **astérisques** et jamais en __underscores__, là où
un linter volontairement désactivé laisserait sinon passer les
deux en silence.
J'ai écrit les rules en dernier, et je me suis ensuite à moitié demandé si elles n'auraient pas dû venir en premier — une rule a l'air d'être la couche la plus « basique ». Mécaniquement, elle ne l'est pas : une rule est définie comme un court extrait de sa skill sœur, donc la skill doit exister avant qu'il y ait quoi que ce soit à extraire. Écrire les skills et les agents avant les rules, même par accident, s'est révélé être le seul ordre qui fonctionne vraiment.
Tout relier ensemble
Une fois que quelques langages ont partagé la même forme skill → agent → command, la carte est devenue la documentation :
| Command | Agent | Skill |
|---|---|---|
/review:bash | bash-best-practices-reviewer | bash-best-practices |
/review:python | python-best-practices-reviewer | python-best-practices |
/review:docker | dockerfile-best-practices-reviewer | dockerfile-best-practices |
Chaque ligne est indépendante et peut être ajoutée seule — une quatrième ligne pour un nouveau langage coûte un fichier skill, un fichier agent et un fichier command, dont aucun ne touche aux trois autres.
Sous le capot (passez si vous voulez juste l'utiliser)
Pourquoi les agents reviewers ne peuvent pas éditer
Read, Grep, Glob, Bash et rien d'autre, ce n'est pas de la prudence pour la prudence. Tout le
travail d'un agent de review est de lire des fichiers qu'il n'a pas écrits et de les juger — dès
qu'il peut aussi Edit, le « détection seulement » cesse d'être une garantie imposée par la liste
d'outils pour devenir une consigne que le prompt se contente de demander. Garder les deux séparés
signifie qu'on peut faire confiance au rapport d'un reviewer pour être exactement cela : un rapport,
pas un diff déjà appliqué sans second regard.
Le script à zéro token, une fois de plus
todo_next_id.sh mérite un deuxième coup d'œil parce qu'il se généralise bien au-delà de la
numérotation des TODO :
#!/usr/bin/env bashset -euo pipefail
# Prints the next .todos/ backlog ID, zero-padded.## Scans every *.md under the given directory and its subfolders (DONE/,# PARTIAL/, BLOCKED/, UNNEEDED/, POSTPONED/, ...), extracts the leading digit# run of each filename regardless of a status prefix, and prints max + 1.# Existing 3-digit IDs and new wider ones coexist fine — only the numeric# value is compared, never the string width.## The prefix is stripped by matching "everything up to the first digit",# not by enumerating specific prefix words/separators — so it copes with a# one-word prefix (DONE_, PARTIAL-), a multi-word one (WONT_DO_, wont-do-),# or no prefix at all, uniformly. A digit run elsewhere in the filename# (a year, an HTTP status code, ...) is never mistaken for the ID, because# only the run immediately following that first stripped prefix is captured.## Usage: todo_next_id.sh [todos-dir] [width]# todos-dir defaults to ./.todos# width zero-padding width for the printed ID, defaults to 4
todos_dir="${1:-.todos}"width="${2:-4}"
max=0if [[ -d "${todos_dir}" ]]; then highest="$(find "${todos_dir}" -type f -name '*.md' -printf '%f\n' | sed -nE 's/^[^0-9]*0*([0-9]{3,}).*/\1/p' | sort -n | tail -1)" [[ -n "${highest}" ]] && max="${highest}"fi
# 10# forces base-10 parsing, otherwise a leading zero (e.g. 020) is read as octalprintf "%0${width}d\n" $((10#${max} + 1))This script finds the highest numbered todo file in a directory (ignoring any status prefixes like DONE_ or PARTIAL-), then prints the next ID number padded with zeros. It scans all .md files recursively, extracts just the numeric ID from each filename, and outputs one higher than the maximum found.
Deux lignes de find/sed/sort répondent à « quel est le prochain ID libre » avec une certitude
totale — aucun risque d'hallucination, puisqu'il n'y a aucun modèle sur le chemin. Son voisin
todo_lock.sh fait la même chose pour un problème plus dur, la concurrence : deux sessions Claude
Code qui courent après le même numéro de TODO le résolvent avec mkdir (atomique — il échoue si le
dossier existe déjà), pas en demandant à l'une des sessions de « vérifier d'abord ». Chaque fois
qu'une étape se réduit à compter, parser, verrouiller, hasher, differ — prenez un script avant de
prendre un prompt.
Conclusion
L'ordre qui a réellement fonctionné ici a été : commands, puis hooks, puis skills couplées à des agents, puis rules — et avec le recul, ce n'est pas un accident à corriger : une rule est mécaniquement un extrait d'une skill, donc skills-avant-rules était le seul ordre viable. Ce qui a changé, ce n'est pas que Claude est devenu plus intelligent de session en session — c'est que le règlement a cessé de vivre dans le chat pour rejoindre la couche faite pour le porter : une limite nette dans un hook, un standard dans une skill, une vérification isolée dans un agent, un réflexe dans une rule, et, partout où la tâche relevait de la pure logique, un script qui n'a jamais rien demandé au modèle.
Une fois qu'un tel dispositif existe, la question suivante est ce qu'il coûte à faire tourner — et c'est précisément là que les astuces d'économie de tokens d'un article précédent prennent le relais.
Cet article fait partie de la série Claude Code :
Chargement des commentaires…