Dessiner une carte de mon propre blog
Construisez une carte interactive de tout votre corpus Docusaurus — chaque article devient une bulle portant la mascotte du site, dimensionnée selon le nombre d'articles qui pointent vers elle, positionnée par un layout force-directed calculé au build dans Node, si bien que le navigateur ne charge jamais d3-force. Inclut le plugin, le composant canvas et le fallback en liste simple qui garde la page utilisable sans JavaScript.


Traduction automatique
Cet article fait partie de la série Créer des composants Docusaurus :
- Modifier la façon dont Docusaurus génère les balises img
- Surcharger la génération des balises img avec Docusaurus
- Organisez votre contenu Docusaurus avec un composant Series personnalisé
- Ajouter un bouton « retour en haut » dans les articles Docusaurus
- Créer un plugin de recherche/remplacement pour Docusaurus
- Un composant pour afficher des snippets de code dans un blog Docusaurus
- Un composant Docusaurus qui prévient le lecteur que l'article a plus d'un an
- Afficher le changelog de votre article
- Injecter de l'ASCII art dans toutes les pages HTML générées par Docusaurus
- Best Practice - Personnaliser le flux RSS de Docusaurus pour un contenu complet et des images
- Quelques vérifications sur les images de votre site Docusaurus
- Gestion des tags dans Docusaurus
- Automatiser les résumés TL;DR avec Gemini AI
- Le composant ProjectSetup - Une façon standardisée de partager des structures de projet
- Comment signaler un contenu assisté par IA dans un blog Docusaurus
- Donnez vie à vos tutoriels CLI avec un terminal machine à écrire
- Espiègleries de suricate : semer des easter eggs partout sur mon blog
- Tooltips de code assistés par l'IA dans Docusaurus — Explique-moi comme à un enfant de cinq ans
- Ajouter des réactions de lecteurs à votre blog Docusaurus
- Votre blog est illisible pour une IA. Voici la solution.
- Secouez votre téléphone, surprenez le suricate
- Ajouter un bouton « Copy as Markdown » à votre blog Docusaurus
- Ask My Blog : transformer 259 articles en 2 160 questions cherchables
- La troisième porte : une bulle de chat flottante, et la fonctionnalité que personne ne trouvait
- Dessiner une carte de mon propre blog
- Laissez vos lecteurs signaler les problèmes — un widget de feedback multi-types pour Docusaurus
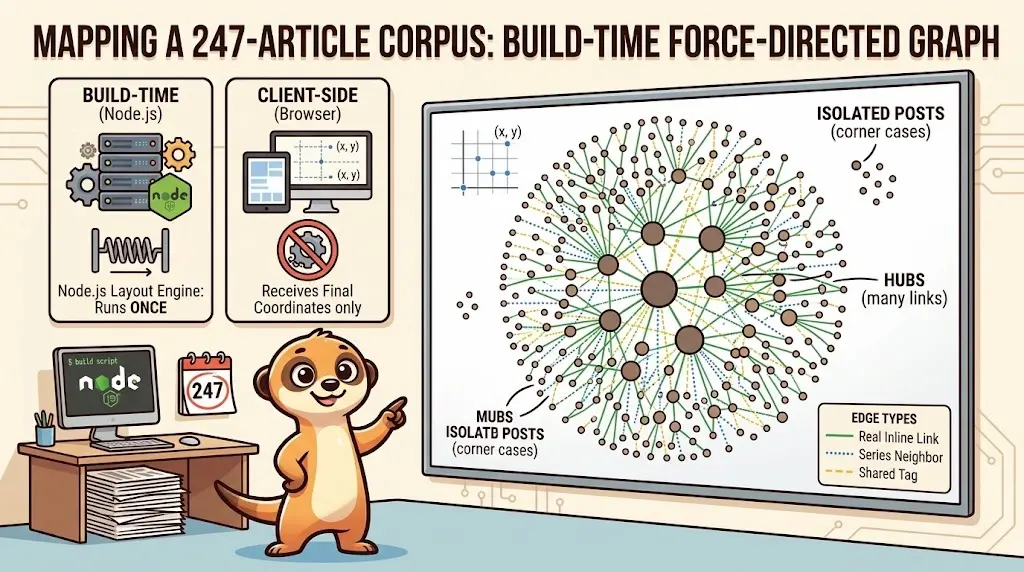
Après 262 articles, je ne savais plus répondre à des questions simples sur mon propre blog : quels billets sont des hubs vers lesquels tout pointe, et lesquels restent seuls dans un coin. J'ai donc construit une page /map — un graphe force-directed de tout le corpus, où chaque article est un point dimensionné selon son degré entrant et relié par trois types d'arêtes (vrais liens inline, voisins de série, tags partagés). L'astuce qui rend ça peu coûteux : le layout est calculé une seule fois, dans Node, au build, donc le navigateur reçoit des coordonnées (x, y) finales et ne charge jamais de moteur physique.
Je publie deux fois par semaine, le lundi et le jeudi, et ça dure depuis un bon moment. Quelque part autour du billet numéro 150, je n'ai plus été capable de répondre à des questions que j'aurais dû connaître par cœur : cet article sur fzf, est-il seulement lié depuis quelque part ? Quel est le billet vers lequel tout le reste renvoie ? Est-ce que toute la série Quarto s'est retrouvée isolée du reste du blog ?
J'avais les données — le frontmatter de chaque article, chaque lien inline — mais aucun moyen de les regarder. Une liste de 262 lignes, ce n'est pas une façon de regarder quoi que ce soit.
J'ai donc construit /map — une page qui dessine le blog sous forme de graphe. Voici comment ça fonctionne et comment en construire une.
Ce que la page carte vous montre
Chaque article publié est une bulle. Plus elle est grosse, plus d'autres articles pointent vers elle. Des lignes relient les billets réellement liés entre eux — survolez-en un et tout ce qui n'est pas son voisin direct s'estompe :
┌─ Blog Map ──────────────────────────────────────────────────────────────────┐
│                                                                             │
│  Filter by topic  [ Top 120 most-linked articles  ▾ ]                       │
│  262 articles · 25 series · 680 internal links                              │
│                                                                             │
│                           Running Docusaurus with Docker                    │
│         ·   ·                     ●                                         │
│       ·  ╲  │ ╱  ·               ╱ ╲                                        │
│     ·──── (◉) ────·             ●   ●───────● Docker-out-of-Docker          │
│       ·  ╱  │ ╲  ·               ╲ ╱                                        │
│         ·   ·                     ●                                         │
│                                                       🦫                    │
│                                              (drawn bigger than its size:   │
│                                               nothing links to this one yet)│
│                                                                             │
│  ▸ View as list instead                                                     │
└─────────────────────────────────────────────────────────────────────────────┘
Trois choses à faire sur cette page :
- Filtrer par sujet avec la liste déroulante pour restreindre le graphe à un seul
mainTag. Les articles qui partagent le tag mais ne sont liés à rien autour d'eux restent visibles — c'est exactement le genre d'orphelin que vous ne remarqueriez jamais autrement. - Survoler un nœud pour voir son titre et mettre en évidence ses connexions directes. Un cluster qui paraît dense de loin se révèle souvent être deux ou trois hubs avec beaucoup de satellites qui ne pointent que vers l'intérieur.
- Passer en liste en bas de page si vous préférez le texte au canvas, ou si vous avez désactivé JavaScript : chaque article est toujours là, groupé par série, entièrement indexé.
Pourquoi calculer le layout au build change tout
Un graphe force-directed, c'est normalement une affaire de navigateur : vous embarquez une bibliothèque physique, vous y déposez les nœuds et vous les regardez se stabiliser pendant quelques secondes. Cette approche échoue sur trois exigences qui comptaient vraiment pour moi, et déplacer la simulation dans Node règle les trois d'un coup.
- La page doit fonctionner sans JavaScript. Si les positions sont déjà finales dans le HTML, la seule chose qu'ajoute JavaScript est le dessin — le chemin sans JS peut donc retomber sur une liste simple, rendue côté serveur et entièrement indexable, de tous les articles, au lieu d'une boîte vide.
- Rien ne doit s'animer tout seul. Il n'y a pas de branche
prefers-reduced-motionà écrire, parce qu'il n'y a aucun mouvement à supprimer : le graphe est déjà au repos à l'instant où il apparaît. d3-forcen'atteint jamais le lecteur. Il reste une dépendance de build. Le navigateur reçoit des nombres, pas un solveur.- Le même build produit la même carte. L'ordre des nœuds est trié avant le démarrage de la simulation, et
d3-forceplace les nœuds à partir de leur index de tableau plutôt que deMath.random(): un rebuild sans changement de contenu reproduit exactement la même image.
Le coût de tout ça, c'est une seconde de plus dans yarn build. C'est le meilleur arbitrage que j'aie fait sur ce blog.
La construire
Deux morceaux : un plugin qui calcule le graphe, et un composant qui le dessine.
Le plugin
Il lit le corpus via le même loader que celui déjà utilisé par mon outillage de tags, construit les arêtes, colore chaque nœud, exécute 300 ticks de simulation et passe le résultat à setGlobalData :
L'exécuter en standalone montre à quoi ressemble la charge utile :
$ node --input-type=module -e "
import('./plugins/blog-graph-plugin/index.mjs').then(async m => {
  const graph = await m.default().loadContent();
  const byType = {};
  for (const edge of graph.edges) byType[edge.type] = (byType[edge.type] ?? 0) + 1;
  console.log('nodes  ', graph.nodes.length);
  console.log('edges  ', graph.edges.length, byType);
  console.log('meta   ', graph.meta);
  console.log('payload', JSON.stringify(graph).length, 'bytes');
});"

nodes   262
edges   1026 { link: 680, series: 144, tag: 202 }
meta    { articleCount: 262, seriesCount: 25, linkCount: 680 }
payload 183292 bytes
262 nœuds, 1026 arêtes, 179 Ko de JSON — calculés une fois au build, plus jamais touchés par le navigateur.
Une décision mérite d'être soulignée : les couleurs des nœuds ne sont pas une nouvelle palette. Un billet appartenant à une série réutilise la couleur d'accent de cette série depuis src/data/series.js — la même que celle dont la page des séries habille son hero. Un billet sans série retombe sur la couleur d'accent extraite automatiquement de son image de bannière. Seul un billet qui n'a ni l'un ni l'autre obtient un gris neutre. La carte ressemble donc au reste du site gratuitement, et un lecteur qui reconnaît déjà « la bleue, c'est la série Quarto » la reconnaît ici aussi.
Le composant
BlogGraph lit ces données globales, les dessine sur un <canvas> et se remplace par une liste simple en dessous de 768px :
Besoin d'aide ? Cliquez sur le bouton « Aide » ci-dessus pour les instructions de mise en place.
Canvas, pas SVG, et ce n'est pas une préférence esthétique : 262 nœuds plus un millier d'arêtes en éléments DOM, et chaque survol devient un recalcul de layout sur un millier de nœuds. Sur un canvas, un survol, c'est un redessin complet de quelques centaines de formes, autant dire rien.
Enregistrez le plugin dans docusaurus.config.js et donnez-lui une page :
plugins: [
  "./plugins/blog-graph-plugin/index.mjs",
  // ...
],
---
title: "Blog Map"
description: "An interactive map of the whole blog."
hide_table_of_contents: true
---

import BlogGraph from "@site/src/components/BlogGraph";

<BlogGraph />
Les trois types de connexion
Une arête signifie « ces deux billets sont liés », mais la parenté a des intensités, et les mélanger à poids égal produit une pelote de laine. Mon corpus émet trois types, chacun avec sa propre traction sur le layout :
| Type | Ce que ça signifie | Nombre | Traction sur le layout |
|---|---|---|---|
link | Le texte d'un billet pointe vraiment vers un autre | 680 | La plus forte — distance 55, force 0.85 |
series | Deux billets consécutifs (par date) dans la même série | 144 | Moyenne — distance 70, force 0.5 |
tag | Deux billets partageant plusieurs tags | 202 | La plus faible — distance 110, pondérée par le poids |
La ligne tag est l'endroit où se cache l'échec intéressant. À cette taille de corpus, presque chaque paire de billets partage au moins un tag — les relier toutes reviendrait à tout relier à tout et détruirait à la fois le layout et l'image. Monter la barre à deux tags partagés laisse encore 1 355 paires, dont 1 153 sont du type le plus faible possible :
shared tags:   2      3     4    5
pairs:       1153    159    40    3
Le plugin fait donc deux choses différentes avec cet ensemble. Le layout utilise toutes les paires jusqu'à deux tags partagés, parce que cette faible traction spatiale est précisément ce qui regroupe « tous mes billets Docker ». La charge utile n'embarque que les paires à trois tags ou plus, parce que rien ne dessine jamais le reste — embarquer la majorité à poids 2 aurait triplé le JSON pour des lignes invisibles. Mêmes données, deux seuils, un pour la physique et un pour le réseau.
Sous le capot (passez si vous voulez juste la carte)
Quatre problèmes qui n'étaient pas évidents avant que la page soit réellement à l'écran.
Un filtre à deux nœuds donnait un canvas géant et vide
Choisissez un sujet de niche dans le filtre et vous obtiendrez peut-être trois articles. Le canvas, lui, restait dimensionné pour 120. Mon premier correctif a été de le dimensionner selon le ratio d'aspect de la bounding box des nœuds visibles — ce qui a échoué, parce que deux articles partageant un mainTag ne sont pas obligés d'être proches dans le layout partagé calculé sur tout le corpus. Deux nœuds aux extrémités opposées produisent un ratio extrême qui revient directement se caler sur la hauteur maximale.
Le deuxième signal, le nombre de nœuds relatif à la vue par défaut, attrape ce cas mais écraserait un cluster réellement haut et compact. computeCanvasHeight() calcule donc les deux et garde le plus petit. Aucun des deux angles morts ne peut produire un canvas surdimensionné à lui seul :
const ratio = contentAspectRatio(nodes) ?? maxRatio;
const aspectHeight = clamp(Math.round(containerWidth * ratio) + padding);

const density = Math.min(nodes.length / defaultTopN, 1);
const densityHeight = clamp(
  Math.round(minHeight + (maxHeight - minHeight) * Math.sqrt(density)),
);

return Math.min(aspectHeight, densityHeight);
Des libellés qui s'empilent les uns sur les autres
Dessiner 262 titres est illisible : seuls les huit nœuds visibles les plus connectés gardent un libellé permanent, auxquels s'ajoutent le nœud survolé et ses voisins directs. Même ça s'empile quand un sujet filtré est chargé. selectNonOverlappingLabels() parcourt les candidats par ordre de priorité — le nœud survolé d'abord, puis les voisins, puis les hubs — mesure chacun avec ctx.measureText() et écarte tout libellé dont la boîte croiserait une boîte déjà placée. Les libellés les moins prioritaires perdent ; celui du nœud survolé gagne toujours.
Un canvas n'entend pas un changement de thème
Les couleurs des nœuds et des arêtes sont lues depuis les variables CSS du site, pour que rien ne soit en dur — mais un canvas est un bitmap, et basculer en mode sombre ne repeint rien. La solution : un MutationObserver sur l'attribut data-theme de <html> qui incrémente un compteur, lequel figure dans le tableau de dépendances de l'effet de redessin :
useEffect(() => {
  const observer = new MutationObserver(() => setThemeVersion((v) => v + 1));
  observer.observe(document.documentElement, {
    attributes: true,
    attributeFilter: ["data-theme"],
  });
  return () => observer.disconnect();
}, []);
Les suricates
Ce blog a une mascotte — elle se cache dans le code source de la page, chevauche le bouton de retour en haut et apparaît sur la page 404. Sur la carte, ce n'est pas une garniture sur quelques nœuds : chaque bulle est un suricate, portant le sticker que lui a valu son mainTag. Les articles PHP tiennent un petit éléphant violet, les articles Bash portent un sweat à capuche, code-quality arrive avec une coche verte. Une trentaine de tags ont un sticker explicite et le reste en tire un de façon déterministe parmi ce qui reste, si bien qu'un sujet a toujours la même tête et que ses articles se lisent comme une famille sur le canvas.
Ce qui fait marcher tout ça, ce sont les images, pas le code : ce sont des portraits carrés, centrés sur le visage. Les poses en pied avec lesquelles j'avais commencé perdaient leur tête dans un recadrage circulaire de 20px, il a donc fallu les choisir et les recadrer une par une ; un portrait centré survit à un simple dessin « cover » sans réglage image par image.
Deux règles empêchent que ça tourne à la bouillie :
- un sticker a besoin de place. En dessous de 12px de diamètre, l'anneau mange un tiers de l'image et un point coloré plat en dit davantage — c'est donc ce que gardent ces nœuds.
- un orphelin est dessiné plus gros. Un nœud avec zéro connexion visible se retrouve au rayon minimal, c'est-à-dire juste sous ce seuil. Il obtient un plancher de 13px à la place, pour que l'unique article vers lequel rien ne pointe soit celui que vous ne pouvez pas rater.
L'anneau autour de chaque bulle conserve la couleur d'accent de l'article, donc rien du signal série/tag n'est perdu au profit de l'illustration.
Conclusion
La carte a fait exactement ce que j'espérais : cinq minutes après son premier rendu, j'avais la liste des billets vers lesquels rien ne pointait, et je voyais qu'une série avait dérivé loin de tout le reste. C'est un outil de maintenance déguisé en jolie image.
La partie qui mérite d'être reprise, pourtant, ce n'est pas le graphe — c'est l'endroit où le travail se fait. Chaque exigence dure de cette page (pas de JavaScript, pas de mouvement, indexable, charge utile légère) s'est dissoute à l'instant où la simulation est passée du navigateur à loadContent(). Les plugins Docusaurus tournent dans Node, avec tout le corpus sous la main et une étape de build que personne n'attend ; ça laisse beaucoup de marge pour calculer les choses correctement, une fois, plutôt que de demander au portable de chaque visiteur de recommencer.
La prochaine fois que vous êtes sur le point d'attraper une bibliothèque côté client, vérifiez si la réponse qu'elle calcule n'aurait pas pu être une constante dans votre sortie de build.
Cet article fait partie de la série Créer des composants Docusaurus :
- Modifier la façon dont Docusaurus génère les balises img
- Surcharger la génération des balises img avec Docusaurus
- Organisez votre contenu Docusaurus avec un composant Series personnalisé
- Ajouter un bouton « retour en haut » dans les articles Docusaurus
- Créer un plugin de recherche/remplacement pour Docusaurus
- Un composant pour afficher des snippets de code dans un blog Docusaurus
- Un composant Docusaurus qui prévient le lecteur que l'article a plus d'un an
- Afficher le changelog de votre article
- Injecter de l'ASCII art dans toutes les pages HTML générées par Docusaurus
- Best Practice - Personnaliser le flux RSS de Docusaurus pour un contenu complet et des images
- Quelques vérifications sur les images de votre site Docusaurus
- Gestion des tags dans Docusaurus
- Automatiser les résumés TL;DR avec Gemini AI
- Le composant ProjectSetup - Une façon standardisée de partager des structures de projet
- Comment signaler un contenu assisté par IA dans un blog Docusaurus
- Donnez vie à vos tutoriels CLI avec un terminal machine à écrire
- Espiègleries de suricate : semer des easter eggs partout sur mon blog
- Tooltips de code assistés par l'IA dans Docusaurus — Explique-moi comme à un enfant de cinq ans
- Ajouter des réactions de lecteurs à votre blog Docusaurus
- Votre blog est illisible pour une IA. Voici la solution.
- Secouez votre téléphone, surprenez le suricate
- Ajouter un bouton « Copy as Markdown » à votre blog Docusaurus
- Ask My Blog : transformer 259 articles en 2 160 questions cherchables
- La troisième porte : une bulle de chat flottante, et la fonctionnalité que personne ne trouvait
- Dessiner une carte de mon propre blog
- Laissez vos lecteurs signaler les problèmes — un widget de feedback multi-types pour Docusaurus
Articles liés


Dessiner une carte de mon propre blog
8 octobre 2026



Ajouter un bouton « Copy as Markdown » à votre blog Docusaurus
10 septembre 2026
Secouez votre téléphone, surprenez le suricate
27 août 2026