Votre blog est illisible pour une IA. Voici la solution.
Une part croissante de vos lecteurs arrive via un assistant IA — et ce qu'ils reçoivent, c'est votre HTML, emballé dans la navigation, des widgets React et des accordéons fermés. Cet article génère un miroir en Markdown pur de chaque article, un index /llms.txt et des bundles full-text par série, en dégradant la source MDX plutôt qu'en convertissant le HTML rendu. Avec la règle de repli qui rend l'export impossible à casser.


Traduction automatique
Cet article fait partie de la série Créer des composants Docusaurus :
- Modifier la façon dont Docusaurus génère les balises img
- Surcharger la génération des balises img avec Docusaurus
- Organisez votre contenu Docusaurus avec un composant Series personnalisé
- Ajouter un bouton « retour en haut » dans les articles Docusaurus
- Créer un plugin de recherche/remplacement pour Docusaurus
- Un composant pour afficher des snippets de code dans un blog Docusaurus
- Un composant Docusaurus qui prévient le lecteur que l'article a plus d'un an
- Afficher le changelog de votre article
- Injecter de l'ASCII art dans toutes les pages HTML générées par Docusaurus
- Best Practice - Personnaliser le flux RSS de Docusaurus pour un contenu complet et des images
- Quelques vérifications sur les images de votre site Docusaurus
- Gestion des tags dans Docusaurus
- Automatiser les résumés TL;DR avec Gemini AI
- Le composant ProjectSetup - Une façon standardisée de partager des structures de projet
- Comment signaler un contenu assisté par IA dans un blog Docusaurus
- Donnez vie à vos tutoriels CLI avec un terminal machine à écrire
- Espiègleries de suricate : semer des easter eggs partout sur mon blog
- Tooltips de code assistés par l'IA dans Docusaurus — Explique-moi comme à un enfant de cinq ans
- Ajouter des réactions de lecteurs à votre blog Docusaurus
- Votre blog est illisible pour une IA. Voici la solution.
- Secouez votre téléphone, surprenez le suricate
- Ajouter un bouton « Copy as Markdown » à votre blog Docusaurus
- Ask My Blog : transformer 259 articles en 2 160 questions cherchables
- La troisième porte : une bulle de chat flottante, et la fonctionnalité que personne ne trouvait
- Dessiner une carte de mon propre blog
- Laissez vos lecteurs signaler les problèmes — un widget de feedback multi-types pour Docusaurus
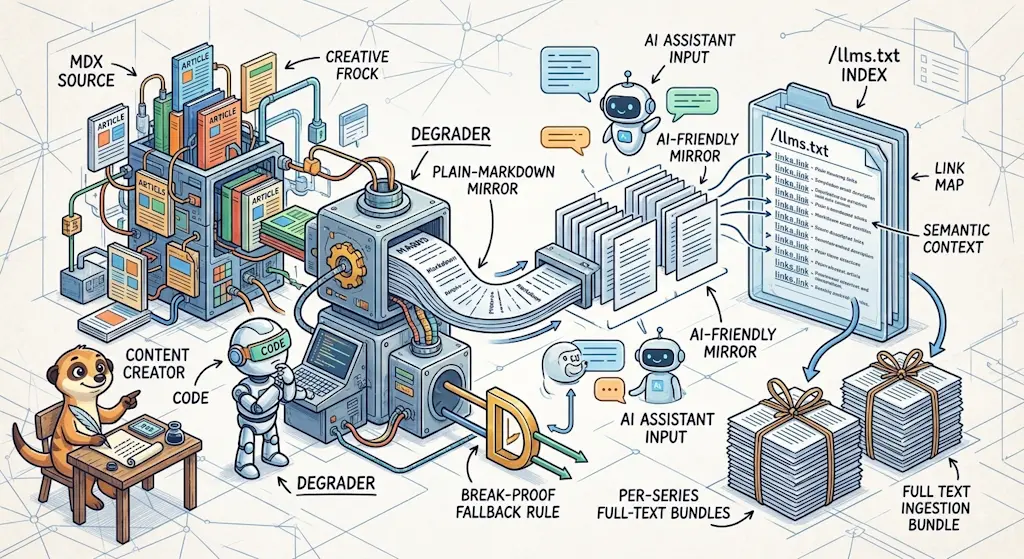
llms.txt est une convention proposée pour rendre un site lisible par les assistants IA — et elle n'a rien de prouvé : aucun assistant majeur (ChatGPT, Claude, Perplexity) ne confirme publiquement le lire. Je l'ai explorée quand même, surtout parce que ce blog est déjà écrit avec Claude Code qui fait l'essentiel du travail sur les fichiers ; maintenir un miroir llms.txt ne coûte donc presque rien. Ce que j'ai découvert en le construisant : le HTML publié, emballé dans la navigation, des widgets React et 107 accordéons <Snippet> fermés, est réellement moins complet que la source que j'ai écrite. La solution est un plugin exécuté au build qui produit un miroir en Markdown pur de chaque article, un index /llms.txt et un bundle full-text par série. La décision clé : dégrader la source MDX, jamais le HTML rendu — et ne jamais laisser un composant inconnu faire échouer l'export.
Je voulais explorer la piste llms.txt, surtout par curiosité, pas parce que j'avais la preuve que des lecteurs arrivaient via un assistant. L'idée — proposée par Jeremy Howard d'Answer.AI en septembre 2024 — est de publier un index d'un site en Markdown pur sur /llms.txt, pour qu'un assistant n'ait pas à se battre contre une application React pour trouver le contenu réel. On est loin d'une pratique établie : ni ChatGPT, ni Claude, ni Perplexity ne confirment publiquement que leur pipeline de récupération lit le fichier, et cela ne prendra peut-être jamais comme robots.txt ou sitemap.xml. Ce qui a fait basculer la balance pour moi : ce blog est déjà écrit avec Claude Code qui fait l'essentiel du travail sur les fichiers, donc garder un miroir llms.txt à jour ne serait pas une corvée manuelle — juste une étape de build en plus. Quand essayer coûte aussi peu, on essaie.
Ce qui est généré
Un yarn build, trois artefacts, tous statiques :
$ yarn build

[markdown-export] Mirroring 247/248 blog posts to Markdown…
[markdown-export] Done — 247 article(s) in /llms.txt, 247/247 mirrored, 0 failed.
Le premier est /llms.txt (voyez le mien en ligne) — l'index du site, au format proposé par llmstxt.org : un titre, un résumé d'une ligne, puis chaque article sous forme de lien accompagné de sa description, groupé par sujet :
# Christophe Avonture

> Personal blog about Docker, WSL, Python, Quarto, PHP, Joomla, Docusaurus and even more

247 articles. Each has a plain-Markdown mirror at its own permalink plus `.md` (e.g. `https://www.avonture.be/blog/<slug>.md`).

## Series (full-text bundles)

Each link is every article in that series, concatenated in reading order — one request instead of many.

- [Bluesky Docusaurus component](https://www.avonture.be/llms/bluesky-docusaurus-component.txt) — 2 article(s)
- [Building and testing REST APIs](https://www.avonture.be/llms/building-and-testing-rest-apis.txt) — 5 article(s)
- [code quality](https://www.avonture.be/llms/code-quality.txt) — 10 article(s)
  … 22 more series …

## component

- [A component for showing code snippets in a Docusaurus blog](https://www.avonture.be/blog/docusaurus-snippets) — Learn how to build a custom React component to embed dynamic code snippets in your Docusaurus blog for a more interactive reader experience.
- [A Docusaurus component that alerts readers the article is over a year old](https://www.avonture.be/blog/docusaurus-old-notice) — Displays a warning banner when the page content is over a year old
  … 245 more articles, grouped under 40 topic headings …
Le deuxième est un miroir en Markdown pur de chaque article, à sa propre URL suffixée de .md. Prenez l'article sur le bouton de retour en haut de page, récupérez /blog/docusaurus-go-top.md, et vous obtenez ceci — pas de JSX, pas d'accordéons, chaque fichier de code intégré en entier :
<!-- canonical-url: https://www.avonture.be/blog/docusaurus-go-top published: 2025-09-12 generated-at: 2026-08-12T14:55:47.056Z This is a static plain-Markdown mirror generated at build time. Visit the canonical URL above for the fully rendered page, with images and interactive components.-->
# Providing a go to the top button in Docusaurus posts
> Learn how to easily add a "go to the top" button, often with a fun animated icon, to your Docusaurus blog posts using a custom React component and theme override.
---
**TL;DR**
This article is a quick tutorial on how to add a 'scroll to top' button to your Docusaurus blog. It walks you through implementing a custom `<ScrollToTopButton>` React component, including its CSS for styling. You'll learn how to override the default `BlogPostItem` theme component to automatically inject the button at the bottom of every blog post. The guide also provides tips on adding the button to other parts of your site, such as the blog archive or custom pages.
More on smartphones than on computers; it's pretty nice to have a *Back to top of page* button to avoid dislocating your thumb.
 [Docux](https://github.com/Juniors017), a friend, recently developed this feature and I was really happy to add it, especially since it's terribly easy to use and adds a fun element; it's cool.
Just scroll down any page of this blog to see a little meerkat appear in the bottom right corner. Click on it and take the lift back to the top of the page.
## What it looks like
Here is this very page, scrolled down. The meerkat sits in the bottom right corner, floating above your own content:
> Screenshot — https\://www\.avonture.be/blog/docusaurus-go-top>> 
Up close, it's a round button holding whatever icon you hand it:
…Ce fichier est un en-tête de document Markdown statique généré automatiquement qui décrit un article de blog Docusaurus sur l'implémentation d'un bouton « retour en haut ». Le contenu explique comment créer un composant React personnalisé pour ajouter cette fonctionnalité aux articles de blog, avec des détails sur le styling et l'intégration dans le thème.
Le troisième est celui auquel je n'aurais pas pensé tout seul : un bundle full-text par série, sur /llms/<series-slug>.txt, qui concatène tous les articles de la série dans l'ordre de lecture. Le bundle Docusaurus components fait 710 Ko de Markdown pur — 23 articles qu'un assistant peut récupérer en une seule requête au lieu de 23.
Pourquoi la source, et jamais le HTML
Tous les outils du domaine reconvertissent le HTML rendu en Markdown. C'est la mauvaise direction, et la raison n'est pas esthétique :
- Le HTML a déjà perdu de l'information. Ce blog replie 107 snippets de code dans des accordéons
<Snippet>fermés, certains composants n'affichent rien avant l'hydratation, et les images sont derrière du lazy loading — un passage HTML → Markdown ne peut récupérer que ce que le HTML contient, et le HTML contient moins que la source. - La source est déjà du Markdown. Un fichier MDX, c'est du Markdown avec un peu de JSX saupoudré dessus. Aller de la source vers le Markdown, c'est gérer quelques dizaines de noms de composants ; aller du HTML vers le Markdown, c'est faire de l'ingénierie inverse sur tout un pipeline de rendu.
- Le fichier généré est réellement meilleur que la page.
<Snippet source="./files/compose.yaml">devient un bloc de code délimité contenant le fichier entier. Le lecteur du miroir obtient le code que le lecteur de la page doit cliquer pour révéler. - Rien n'est inventé. Chaque composant de ce blog emballe soit du contenu écrit par l'auteur, soit pointe vers un fichier sur le disque. Aucun composant ne fabrique du contenu à l'exécution — une dégradation au niveau de la source peut donc être complète par construction.
Le résultat n'est pas un export dégradé de mon site. C'est une version plus complète.
La mise en place
La table de dégradation
Mes articles ne sont pas du Markdown pur : c'est du MDX, du Markdown mélangé à quelques dizaines de composants React maison — <Snippet> pour un bloc de code repliable, <AlertBox> pour un encart, <Link> pour une référence croisée, et ainsi de suite. Chacun existe pour ajouter un peu d'interactivité à la page, et chacun est exactement ce qu'un miroir Markdown ne peut pas rendre tel quel. Le plugin doit donc savoir, composant par composant, en quel Markdown pur le transformer. Le tout est un pipeline remark : parser la source MDX en AST, la parcourir, remplacer chaque nœud JSX par des nœuds Markdown purs, puis sérialiser. Chaque composant a sa règle :
| Composant | Utilisations | Dégradation |
|---|---|---|
Snippet | 917 | bloc délimité ; source= (841×) résolu et intégré en entier |
Link | 779 | [text](href) |
AlertBox | 546 | > **{title}:** … (le variant devient le mot-clé) |
Terminal | 455 | bloc ```bash ; source= (146×) résolu |
TLDR | 253 | > **TL;DR** … |
BrowserWindow | 98 | les enfants, plus une légende > Screenshot — {url} |
StepsCard | 55 | liste ordonnée |
ProjectSetup | 28 | ### Project: {folderName} puis chaque Snippet en bloc titré |
Details | 18 | laissé en <details> — déjà du Markdown valide |
Prerequisite | 10 | liste à puces |
Columns / Column | 9 | sections successives |
Reaction, ScrollToTopButton, Bluesky, RelatedPosts, … | ~15 | supprimés — de l'interface, pas du contenu |
Trees / Folder / File | 0 | rien à faire (voir ci-dessous) |
Cette dernière ligne est ma préférée dans tout le plugin. Ces composants existent parce qu'un plugin remark transforme une arborescence ASCII de la source en composants React. Ne pas appliquer ce plugin restitue l'arborescence ASCII d'origine, gratuitement. La bonne règle était de n'écrire aucune règle.
L'orchestrateur
Le plugin s'exécute dans postBuild, dégrade chaque article publié, écrit les miroirs, puis construit les deux index à partir de ce qui a réussi :
Enregistrez-le comme n'importe quel autre plugin :
plugins: [
  "./plugins/markdown-export-plugin/index.cjs",
  // ...
],
Auto-hébergé ? Attention au type MIME
/blog/my-slug (comme /blog/docusaurus-llms-txt pour cet article) est un répertoire contenant index.html, donc son voisin /blog/my-slug.md ne crée aucun conflit de route — celui-là est gratuit. Mais Apache n'a aucun mapping MIME natif pour .md, donc sans AddType text/markdown .md dans .htaccess, le navigateur propose un téléchargement au lieu d'afficher le fichier.
La seule règle qui rend tout ça sûr
Un composant inconnu ne fait jamais échouer l'export. Son wrapper est supprimé et ses enfants prennent sa place. Aucune exception, aucune erreur, jamais.
C'est cette unique règle qui permet à une table de dégradation de 900 lignes de vivre dans un pipeline de build sans devenir un risque. Ajoutez un composant dans six mois, oubliez d'écrire sa règle, et le pire cas est que son wrapper disparaisse alors que son contenu survit.
Mais un repli silencieux est une fuite lente : le plugin enregistre donc chaque composant qu'il n'a pas reconnu et avertit une fois par build. C'est cet avertissement, pas la table, qui maintient la couverture à 100 % dans le temps — la table est figée le jour où vous l'écrivez ; l'avertissement remarque le jour où vous la cassez.
Rendre le tout découvrable
Générer un fichier n'est pas le publier : sans lien qui pointe vers lui, personne — crawler ou humain — ne trouve /llms.txt ou un bundle de série tout seul. Quatre points d'accroche comblent ce manque, chacun visant un consommateur différent :
1. llms.txt référence ses propres bundles. L'index s'ouvre sur une section « Series (full-text bundles) ». C'est le seul endroit où ils sont référencés.
2. Un <link rel="alternate"> à l'échelle du site, dans headTags, pour qu'il soit rendu côté serveur sur chaque page — exactement la façon dont on a toujours découvert le RSS :
{
  tagName: "link",
  attributes: {
    rel: "alternate",
    type: "text/markdown",
    href: "https://www.avonture.be/llms.txt",
    title: "llms.txt — full site index in Markdown, for LLMs and readers",
  },
},
3. Un équivalent par article, pointant vers le miroir de cet article, injecté par un composant minuscule branché sur la page d'article :
// Points crawlers/tools that scan <link rel="alternate"> at this exact// article's plain-Markdown mirror (written by plugins/markdown-export-plugin,// see src/components/CopyAsMarkdown for the human-facing equivalent). Same// discovery pattern as RSS's <link rel="alternate" type="application/rss+xml">,// scoped to a single page instead of the whole site — the site-wide// counterpart (pointing at /llms.txt) lives in docusaurus.config.js's// headTags, since that one applies to every page, not just blog posts.import type { JSX } from "react";import Head from "@docusaurus/Head";import { useBlogPost } from "@docusaurus/plugin-content-blog/client";import { translate } from "@docusaurus/Translate";
export default function MarkdownAlternate(): JSX.Element { const { metadata } = useBlogPost();
return ( <Head> <link rel="alternate" type="text/markdown" href={`${metadata.permalink}.md`} title={translate({ id: "markdownAlternate.title", message: "Plain-Markdown mirror of this article", })} /> </Head> );}This React component adds a discovery link to each blog post's HTML head, pointing crawlers and tools to a plain-Markdown version of the article. It works similarly to how RSS feeds advertise themselves with alternate links, but scoped to individual pages rather than the entire site.
4. Un fil d'Ariane dans robots.txt. Il n'existe aucune directive standard pour ça — c'est un commentaire, lu par tout ce qui parse déjà ce fichier et en cherche un. Ça a coûté deux lignes.
Une limitation, honnêtement
Le lien destiné aux humains « View this series as plain Markdown » sur /series/<slug> est invisible pour un crawler qui n'exécute pas JavaScript : cette page est une route React Router côté client, donc son lien n'apparaît jamais dans le HTML rendu côté serveur. Les deux balises <link rel="alternate"> ci-dessus n'ont pas ce problème — et c'est précisément pour ça que les points de découverte qui comptent vivent dans headTags et dans un composant, pas dans le corps d'une page.
Et puis il y a la partie qu'aucun code ne fera pour vous : soumettre aux annuaires. Les bons sont ceux vers lesquels la page officielle de la spec renvoie. J'ai réussi à m'enregistrer sur llmstxt.site et directory.llmstxt.cloud ; llmstxthub.com avait un formulaire de soumission cassé le jour où j'ai essayé. Dix minutes bien investies.
Conclusion
Ce que j'aime dans le résultat a moins à voir avec l'adoption par les IA que je ne l'imaginais au départ :
- N'importe qui peut faire un
curlsur un article et l'obtenir en entier. Pas seulement un bot — un script, un collègue, moi sur une connexion lente — obtient le texte complet, sans HTML, sans JavaScript, sans navigation à nettoyer à la main d'abord. - Le blog est bot-friendly, que
llms.txtprenne ou non. Une version en Markdown pur de chaque article existe maintenant comme effet de bord, indépendamment du sort de cette convention. - Un fichier Markdown tombe directement dans un éditeur de texte ou dans la fenêtre de contexte d'un LLM. Plus besoin de tout sélectionner et de supprimer la barre de navigation avant qu'un article soit réellement utilisable ailleurs.
/llms.txtfait aussi office d'inventaire du blog — chaque article, une ligne chacun, groupé par sujet. Une table des matières que je n'avais pas avant, générée gratuitement.- Les bundles par série transforment 23 requêtes en une. Pratique pour un assistant qui récupère du contexte, tout aussi pratique pour un lecteur qui veut une série entière dans un seul fichier, à lire ou à archiver.
- Rien de tout ça n'a besoin d'être retenu. C'est une étape de build, pas une habitude — et c'est exactement pour ça qu'une convention non prouvée méritait une heure d'essai.
Si les 107 accordéons <Snippet> fermés qui ont déclenché toute cette histoire sont nouveaux pour vous, ce composant mérite sa propre lecture.
Cet article fait partie de la série Créer des composants Docusaurus :
- Modifier la façon dont Docusaurus génère les balises img
- Surcharger la génération des balises img avec Docusaurus
- Organisez votre contenu Docusaurus avec un composant Series personnalisé
- Ajouter un bouton « retour en haut » dans les articles Docusaurus
- Créer un plugin de recherche/remplacement pour Docusaurus
- Un composant pour afficher des snippets de code dans un blog Docusaurus
- Un composant Docusaurus qui prévient le lecteur que l'article a plus d'un an
- Afficher le changelog de votre article
- Injecter de l'ASCII art dans toutes les pages HTML générées par Docusaurus
- Best Practice - Personnaliser le flux RSS de Docusaurus pour un contenu complet et des images
- Quelques vérifications sur les images de votre site Docusaurus
- Gestion des tags dans Docusaurus
- Automatiser les résumés TL;DR avec Gemini AI
- Le composant ProjectSetup - Une façon standardisée de partager des structures de projet
- Comment signaler un contenu assisté par IA dans un blog Docusaurus
- Donnez vie à vos tutoriels CLI avec un terminal machine à écrire
- Espiègleries de suricate : semer des easter eggs partout sur mon blog
- Tooltips de code assistés par l'IA dans Docusaurus — Explique-moi comme à un enfant de cinq ans
- Ajouter des réactions de lecteurs à votre blog Docusaurus
- Votre blog est illisible pour une IA. Voici la solution.
- Secouez votre téléphone, surprenez le suricate
- Ajouter un bouton « Copy as Markdown » à votre blog Docusaurus
- Ask My Blog : transformer 259 articles en 2 160 questions cherchables
- La troisième porte : une bulle de chat flottante, et la fonctionnalité que personne ne trouvait
- Dessiner une carte de mon propre blog
- Laissez vos lecteurs signaler les problèmes — un widget de feedback multi-types pour Docusaurus
Chargement des commentaires…
Articles liés


Dessiner une carte de mon propre blog
8 octobre 2026



Ajouter un bouton « Copy as Markdown » à votre blog Docusaurus
10 septembre 2026