Afficher les articles liés sous nos articles Docusaurus
Améliorez votre blog Docusaurus en affichant les articles liés sous chaque article pour faciliter la découverte de contenu.

Traduction automatique
Cet article a plus d'un an, mais il a été relu le 30 juillet 2026 — son contenu est toujours exact.
Ce guide explique comment ajouter une section « Articles liés » sous vos articles de blog Docusaurus. Vous allez apprendre à créer un composant React <RelatedPosts> personnalisé qui affiche une liste d'articles partageant le même tag principal (mainTag). La démarche consiste à construire un composant <Card> réutilisable, à créer un script utilitaire pour récupérer et parser les données des articles, et enfin à surcharger le thème BlogPostItem de Docusaurus pour injecter votre nouveau composant en bas de chaque article.
Docusaurus peut afficher une liste de tags, mais pas d'articles liés. Ce mainTag n'est utile que si vos tags sont cohérents ; Gestion des tags dans Docusaurus présente le script de nettoyage que j'utilise pour qu'ils le restent.
Quand vous parcourez mon blog, vous voyez une liste d'articles liés sous chaque article. C'est un composant que j'ai codé avec l'aide de l'IA. Pour les articles qui suivent un ordre de lecture voulu plutôt qu'un tag commun, voyez Organisez votre contenu Docusaurus avec un composant Series personnalisé.
L'objectif de notre composant est d'afficher quelque chose comme ceci :
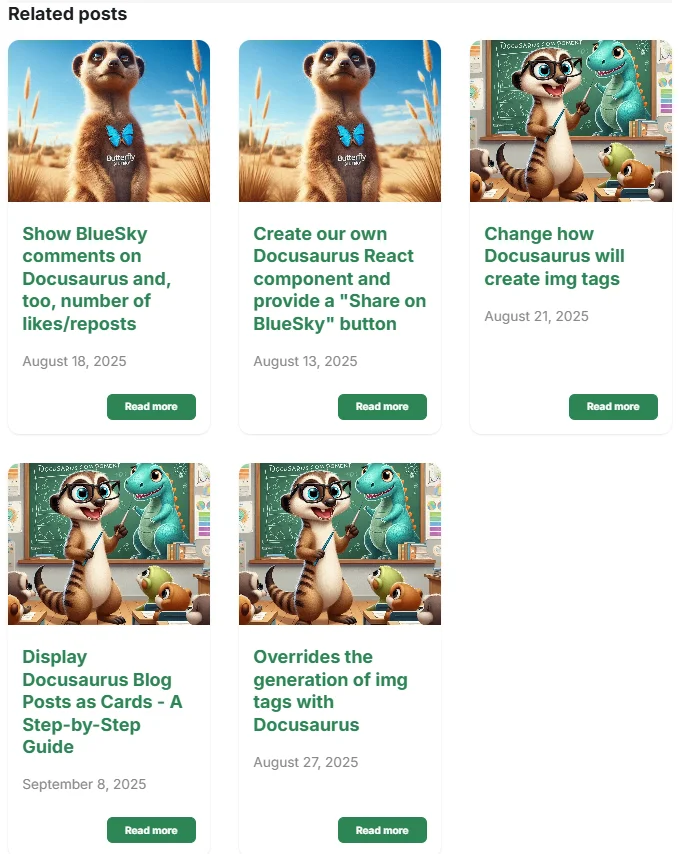
Voici le résultat final une fois le tout branché : jusqu'à six cartes, choisies parmi les articles partageant le même mainTag.
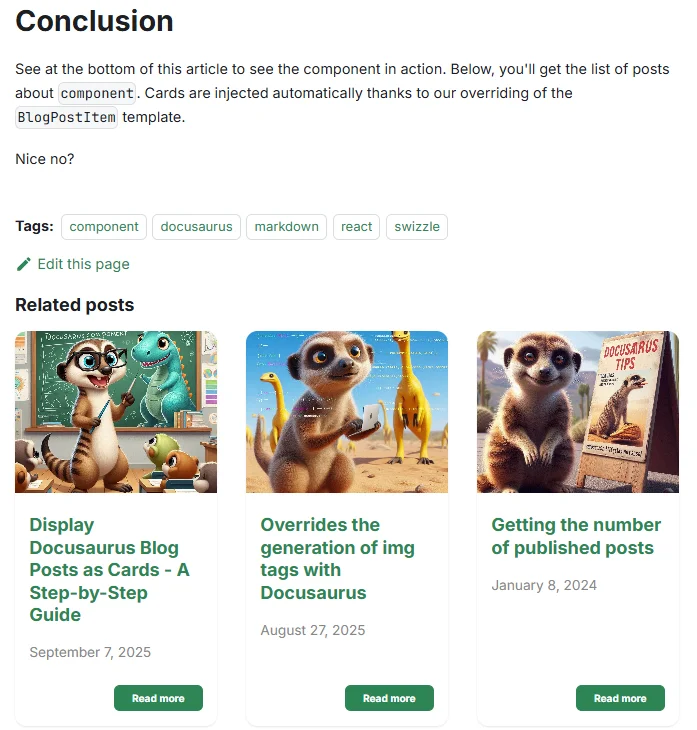
Pourquoi ça fonctionne
- La correspondance se fait sur
mainTag, un seul champ de front matter personnalisé — pas de sélection manuelle, pas de pondération de mots-clés, juste « même sujet principal ». - Le composant
<RelatedPosts>réutilise le même<Card>que vous construiriez pour n'importe quelle liste d'articles, donc il n'y a qu'une seule mise en page de carte à maintenir sur tout le site. - C'est une surcharge de thème, pas un fork :
BlogPostItemaffiche toujours tout ce que Docusaurus fait normalement, on injecte simplement un composant en plus tout en bas.
Il nous faut un composant Card
Suivez les instructions du chapitre Utiliser le composant Card réutilisable de Docux.
Vous devrez créer jusqu'à cinq fichiers dans un dossier src/components/Card/ (et ses sous-dossiers).
Revenez à cet article une fois les cinq fichiers créés.
Il nous faut un moyen d'extraire les informations des articles
Si ce n'est pas déjà fait, créez le fichier src/components/Blog/utils/posts.ts. Il contiendra une fonction utilitaire réutilisable par plusieurs composants.
Cette fonction va scanner chaque fichier Markdown avec une extension .md ou .mdx dans le sous-dossier blog.
Pour chaque fichier, le script va regarder le front matter YAML et utiliser certaines de ses propriétés. Par exemple :
- Si l'article a
draft: trueouunlisted: true, il sera ignoré. - Si l'article a un
slug, il sera utilisé. Sinon, le slug sera généré par le code. - Si l'article a une image associée, elle sera utilisée. Sinon, une image par défaut sera utilisée.
- Ensuite, la fonction retournera la liste des articles et leurs propriétés.
Certaines propriétés, comme mainTag, sont personnalisées.
Copiez-collez donc le contenu du fichier ci-dessous et créez le fichier src/components/Blog/utils/posts.ts dans la structure de votre projet.
/** * getBlogMetadata * * Extracts metadata from all MDX blog posts located in the `/blog` directory. * Uses Webpack's `require.context` to dynamically load and parse frontmatter * from each post, returning a structured array of metadata objects. * * Behavior: * - Resolves permalinks based on `slug` or folder structure * - Normalizes image paths for static assets * - Filters out invalid or missing entries * * Returned metadata includes: * - `title`: Post title * - `description`: Short summary * - `image`: Resolved image path * - `draft`: Boolean flag for unpublished posts * - `unlisted`: Boolean flag for hidden posts * - `permalink`: URL path to the post * - `tags`: Array of tags * - `mainTag`: Primary tag (optional); used by the RelatedBlogPost component * - `authors`: Array of author names * - `date`: Publication date * - `series`: Series name (optional); used by the SeriesBlogPost component * * Usage: * ```ts * import { getBlogMetadata } from './posts'; * const posts = getBlogMetadata(); * const withDrafts = getBlogMetadata({ includeDrafts: true }); * ``` * * By default, posts flagged `draft` or `unlisted` are excluded so consumers don't have to * remember to filter them out themselves. Pass `includeDrafts`/`includeUnlisted` to opt back in * (e.g. author-facing counters that need to show "in progress" articles). * * Note: * This function is intended for use in static site generation or client-side rendering * where Webpack's `require.context` is available. */
/** * A tag as it reaches these helpers: a plain slug string from front matter, or — * defensively, since related.ts and TagArticlesPage both handle it — a * Docusaurus-normalised tag object. */export type BlogTag = string | { label: string };
export interface BlogPostMetadata { authors: string[]; blueskyRecordKey: string | null; /** * ISO date string from front matter, e.g. "2026-08-28". Every article under blog/ carries * one (blog authoring convention, and the blog plugin itself refuses a post without a * date), so this is not optional. * * Runtime note: plugins/frontmatter-loader actually hands back a real `Date` instance for * a typical unquoted YAML date (see that plugin's own header comment) — not a string. * Declaring `string` here anyway matches the pre-existing contract every niveau 1-4 `.tsx` * consumer already compiles against (`Post.date?: string`, …); every one of them passes * this straight into `new Date(...)`, which accepts a `Date` argument just as well as a * string, so nothing behavioral changes. Widening this to the more literally accurate type * would ripple into every already-migrated consumer — out of scope here. */ date: string; description: string | undefined; draft: boolean; image: string | undefined; mainTag: string | null; permalink: string; series: string | null; tags: BlogTag[]; title: string; unlisted: boolean;}
interface RawFrontMatter { title?: string; slug?: string; image?: string; authors?: string[]; blueskyRecordKey?: string; date?: BlogPostMetadata["date"]; description?: string; draft?: boolean; mainTag?: string; series?: string; tags?: BlogTag[]; unlisted?: boolean;}
// The `!!…!` prefix is load-bearing, do not simplify it away: it bypasses the// rules configured by @docusaurus/plugin-content-blog and reads the files with// plugins/frontmatter-loader instead. Without it, Webpack MDX-compiles every// file under `blog/`, and any article flagged `draft: true` crashes the// production build with "Blog post not found for filePath=…" — because the blog// plugin drops drafts from its post list while this context still pulls them in.// See plugins/frontmatter-loader/index.cjs for the full story.import { useTranslationState, slugFromPermalink } from "./translations";
const posts = require.context( "!!../../../../plugins/frontmatter-loader/index.cjs!../../../../blog", true, /\.mdx?$/,);
// Second corpus: the French translations. Needed because the context above reads `blog/` — the// English source — whatever locale is being rendered, so every card, list and related-post// block showed an English title on a French page even for articles that ARE translated.//// The locale is spelled out rather than computed: `require.context` is a webpack construct and// its path must be statically analysable. Adding a locale means adding a context here.const translatedPosts = require.context( "!!../../../../plugins/frontmatter-loader/index.cjs!../../../../i18n/fr/docusaurus-plugin-content-blog", true, /\.mdx?$/,);
/** slug -> the translated `title`/`description`, for the one non-default locale we ship. */function buildTranslatedFrontMatter(): Map<string, { title: string; description: string }> { const bySlug = new Map<string, { title: string; description: string }>();
for (const key of translatedPosts.keys()) { const post = translatedPosts(key) as { frontMatter: RawFrontMatter }; if (!post.frontMatter?.title) continue;
const dir = key.replace(/\/index\.mdx?$/, "").replace(/^\.\//, ""); const slug = post.frontMatter.slug ? post.frontMatter.slug.replace(/^\/+|\/+$/g, "").replace(/^blog\//, "") : dir.split("/").pop() ?? "";
if (slug) { bySlug.set(slug, { title: post.frontMatter.title, description: post.frontMatter.description ?? "", }); } }
return bySlug;}
const TRANSLATED_FRONT_MATTER = buildTranslatedFrontMatter();
export function getBlogMetadata({ includeDrafts = false, includeUnlisted = false,}: { includeDrafts?: boolean; includeUnlisted?: boolean } = {}): BlogPostMetadata[] { return posts .keys() .map((key): BlogPostMetadata | null => { const post = posts(key) as { frontMatter: RawFrontMatter };
// A Markdown file under `blog/` without a title is not an article // (a fragment, a note, a readme…); the blog plugin ignores it, so do we. if (!post.frontMatter?.title) { return null; }
const dir = key.replace(/\/index\.mdx?$/, "").replace(/^\.\//, "");
let permalink: string; if (post.frontMatter.slug) { permalink = post.frontMatter.slug.startsWith("/") ? post.frontMatter.slug : `/blog/${post.frontMatter.slug.replace(/^\//, "")}`; } else { permalink = `/blog/${dir}/`; }
let imageUrl = post.frontMatter.image; if (imageUrl && imageUrl.startsWith("./")) { imageUrl = `/blog/${dir}/${imageUrl.replace("./", "")}`; }
return { authors: post.frontMatter.authors || [], blueskyRecordKey: post.frontMatter.blueskyRecordKey || null, date: post.frontMatter.date as BlogPostMetadata["date"], description: post.frontMatter.description, draft: post.frontMatter.draft || false, image: imageUrl, mainTag: post.frontMatter.mainTag || null, permalink, series: post.frontMatter.series || null, tags: post.frontMatter.tags || [], title: post.frontMatter.title, unlisted: post.frontMatter.unlisted || false, }; }) .filter((post): post is BlogPostMetadata => post !== null) .filter( (post) => (includeDrafts || !post.draft) && (includeUnlisted || !post.unlisted), );}
/** * Locale-aware counterpart of `getBlogMetadata()` — the one every rendering surface should use. * * `getBlogMetadata()` reads `blog/` through `require.context`, so it always returns the **English** * corpus, whatever locale the page is being rendered in. Left unfiltered, a French listing shows * entries whose titles are English and whose pages open on English prose — which reads as a broken * site rather than as a partially translated one. * * On the default locale this is `getBlogMetadata()` unchanged, so switching a call site over is * always safe. * * Note this filters, it does not translate: the titles and descriptions of the surviving entries * still come from the English source. Showing the translated ones is a separate (larger) job — * see TODO 0119, lot C, "rendre le corpus de posts.ts conscient de la locale". */export function useBlogMetadata( options: { includeDrafts?: boolean; includeUnlisted?: boolean } = {},): BlogPostMetadata[] { const { filterTranslated, isDefaultLocale } = useTranslationState();
const visible = filterTranslated(getBlogMetadata(options), (post) => slugFromPermalink(post.permalink), );
if (isDefaultLocale) return visible;
// Overlay the translated title and description. Only these two are localized: `permalink`, // `image`, `tags`, `series` and `date` are shared with the English source by design — the // translation copies them byte for byte (see the translation contract in TODO 0119). return visible.map((post) => { const translated = TRANSLATED_FRONT_MATTER.get(slugFromPermalink(post.permalink)); if (!translated) return post;
return { ...post, title: translated.title, description: translated.description || post.description, }; });}This file extracts metadata from MDX blog posts using Webpack's dynamic loading, parsing frontmatter (the metadata at the top of each file) to build a structured list of post information. It handles both English posts and French translations, allowing callers to include or exclude draft and unlisted posts as needed. The main `getBlogMetadata()` function reads raw post data, while `useBlogMetadata()` adds locale awareness by overlaying translated titles and descriptions for non-English pages.
Notre composant RelatedPosts
Créez maintenant le fichier src/components/Blog/RelatedPosts/index.tsx :
/** * 🔗 RelatedPosts Component * * Displays a list of related blog posts based on shared tags or a designated `mainTag`. * Designed for Docusaurus blogs to enhance content discoverability. * * Behavior: * - Uses `useBlogPost()` to get current post metadata * - Delegates the selection to `useRelatedPosts()` (mainTag, then fallback on shared tags, * current post excluded, newest first) so this block and `MobileQuickLinks` stay in sync * * Styling: * - Uses Docusaurus grid and card classes * - Inline styles for layout and visual polish * * Returns: * - A responsive grid of related blog post cards, or a fallback message if none found */
import type { JSX } from "react";import { useBlogPost } from "@docusaurus/plugin-content-blog/client";import Translate from "@docusaurus/Translate";import { useRelatedPosts } from "@site/src/components/Blog/utils/related";import PostCard from "@site/src/components/Blog/PostCard";import styles from "./styles.module.css";
interface Props { /** Number of related posts to display */ count?: number; /** Whether to show post descriptions */ description?: boolean;}
export default function RelatedPosts({ count = 3, description = false,}: Props): JSX.Element | null { const { metadata } = useBlogPost(); // `mainTag` is a project-specific front matter field, so Docusaurus types it // as `unknown` — narrow it to what useRelatedPosts() expects. const mainTag = metadata.frontMatter.mainTag as string | undefined; const tags = metadata.frontMatter.tags || [];
// Hook before early return: useRelatedPosts reads the locale-aware corpus, and it already // returns [] when there is no tag to match on. const related = useRelatedPosts({ mainTag, tags, excludePermalink: metadata.permalink, count, });
if (!mainTag && tags.length === 0) { return null; }
if (!related.length) { return ( <p> <Translate id="blog.relatedPosts.noRelated">No related posts.</Translate> </p> ); }
return ( <div className={styles.relatedPosts}> <h3> <Translate id="blog.relatedPosts.title">Related posts</Translate> </h3> <div className="row"> {related.map((post) => ( <PostCard key={post.permalink} layout="small" post={description ? post : { ...post, description: null }} /> ))} </div> </div> );}This component displays a grid of blog posts related to the current post, either by a designated main tag or by shared tags. It retrieves the current post's metadata and tag information, fetches matching related posts through a helper hook, and renders them as cards, with fallback handling for when no related posts exist.
Surcharger le template BlogPostItem
Nous devons maintenant surcharger le template BlogPostItem de Docusaurus pour pouvoir injecter notre composant <RelatedPosts> en bas de chaque article.
Dans un terminal, lancez yarn docusaurus swizzle @docusaurus/theme-classic BlogPostItem, puis sélectionnez Javascript, ensuite Eject, et enfin YES.
Beaucoup de fichiers seront créés dans le dossier src/theme/BlogPostItem de votre projet Docusaurus. On peut supprimer sans risque tous les fichiers sauf src/theme/BlogPostItem/index.js, que nous devons éditer.
Supprimez donc tous les fichiers et dossiers sous src/theme/BlogPostItem à l'exception du fichier index.js.
Dans le code ci-dessous, les lignes surlignées sont celles que nous devons ajouter.
import { useBlogPost } from "@docusaurus/plugin-content-blog/client";import BlogPostItemContainer from "@theme/BlogPostItem/Container";import BlogPostItemContent from "@theme/BlogPostItem/Content";import BlogPostItemFooter from "@theme/BlogPostItem/Footer";import BlogPostItemHeader from "@theme/BlogPostItem/Header";import clsx from "clsx";
import RelatedPosts from "@site/src/components/Blog/RelatedPosts";
// apply a bottom margin in list viewfunction useContainerClassName() { const { isBlogPostPage } = useBlogPost(); return !isBlogPostPage ? "margin-bottom--xl" : undefined;}export default function BlogPostItem({ children, className }) { // We need to retrieve the isBlogPostPage flag const { metadata, isBlogPostPage } = useBlogPost(); const containerClassName = useContainerClassName(); return ( <BlogPostItemContainer className={clsx(containerClassName, className)}> <BlogPostItemHeader /> <BlogPostItemContent>{children}</BlogPostItemContent> <BlogPostItemFooter /> // highlight-next-line {isBlogPostPage && <RelatedPosts count="6" description="false" />} </BlogPostItemContainer> );}Ce composant affiche un article de blog avec son en-tête, son contenu et son pied de page. Il ajoute une marge inférieure quand l'article est affiché dans une liste plutôt que sur sa propre page, et montre une section d'articles connexes uniquement quand on consulte la page complète de l'article.
Maintenant, comme nous venons d'introduire une surcharge, nous devons redémarrer notre serveur Docusaurus pour que les changements prennent effet.
Lancez npm run start
Si vous faites tourner Docusaurus en local, lancez simplement npm run start dans votre console.
Si, comme moi, vous faites tourner Docusaurus avec Docker, arrêtez le container et démarrez-en un nouveau.
Éditer nos articles de blog
Nous avons fait toute la configuration nécessaire, mais quand vous visitez votre blog, vous ne voyez rien qui ressemble à « Articles liés ». Pourquoi ?
Par exemple, dans l'image ci-dessous, on ne voit aucune carte.
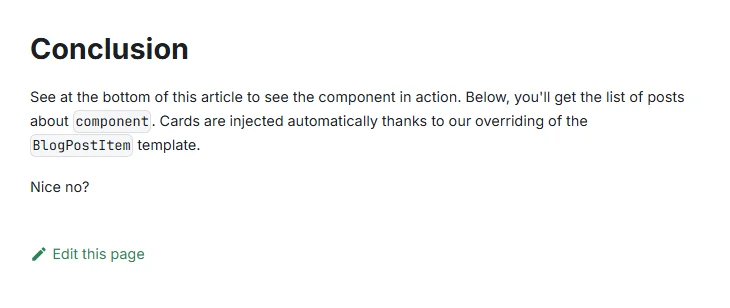
C'est parce qu'il nous faut deux choses :
- 1. Votre article doit avoir un
mainTaget - 2. Les articles de votre blog doivent avoir un tableau
tags
Regardez l'exemple ci-dessous :
---date: 2025-09-03slug: docusaurus-relatedpoststitle: Displaying related posts below our Docusaurus articleauthors: [christophe]image: /img/social-card.webpseries: Creating Docusaurus components# highlight-startmainTag: docusaurustags: [component, docusaurus, markdown, react, swizzle]# highlight-end---Ce fichier contient les métadonnées d'un article de blog Docusaurus, incluant la date de publication, un identifiant URL, le titre, l'auteur et des tags de catégorisation. Les lignes 8 à 11 marquent une section surlignée pour la mise en évidence visuelle dans le rendu final.
L'article doit avoir un élément mainTag, associé au tag le plus important pour cet article. Disons docusaurus.
Ensuite, tous les articles de votre blog doivent avoir le tableau tags standard, dans lequel vous pouvez lister plusieurs tags.
Le composant RelatedPosts va alors chercher docusaurus dans vos articles et afficher jusqu'à six cartes — le résultat déjà montré en haut de cet article.
Conclusion
Un champ mainTag, une fonction utilitaire posts.ts, un <Card> que vous avez probablement déjà, et une surcharge de thème : voilà toute la recette d'un bloc « Articles liés » qui ne demande aucune sélection manuelle. Voyez Organisez votre contenu Docusaurus avec un composant Series personnalisé pour les articles qui suivent un ordre de lecture voulu plutôt qu'un tag commun, et Gestion des tags dans Docusaurus pour garder vos mainTag/tags cohérents sur tout le blog.
Chargement des commentaires…
Articles liés


Dessiner une carte de mon propre blog
8 octobre 2026



Ajouter un bouton « Copy as Markdown » à votre blog Docusaurus
10 septembre 2026
Secouez votre téléphone, surprenez le suricate
27 août 2026