hyperfine — arrêtez de deviner quelle commande est la plus rapide, mesurez-la
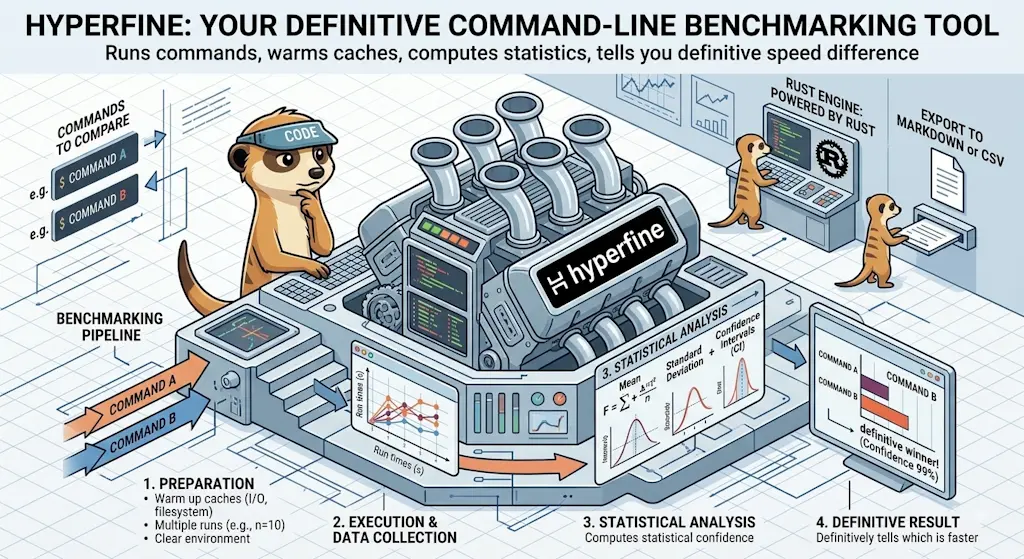
hyperfine est un outil de benchmark en ligne de commande écrit en Rust. Il exécute vos commandes de nombreuses fois, gère les runs de warmup, calcule des statistiques sur le temps et la mémoire, et vous dit définitivement laquelle est la plus rapide — avec export en Markdown, CSV ou JSON.


Traduction automatique
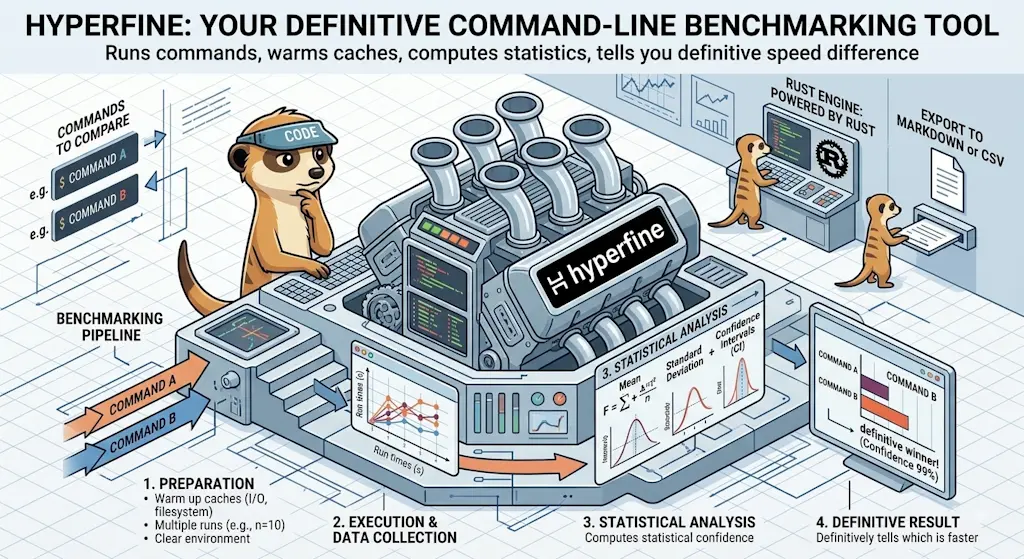
hyperfine est un outil de benchmark en ligne de commande qui exécute vos commandes de nombreuses fois, chauffe les caches disque à la demande, vous avertit des valeurs aberrantes et rapporte le temps moyen, l'écart-type, le pic mémoire et une comparaison relative. Une seule commande pour trancher définitivement : ripgrep est-il plus rapide que grep sur votre machine ? Votre build Docker optimisé est-il réellement plus rapide ? Plus de devinettes, plus de chronomètre — juste des chiffres.
Vous avez remplacé grep par ripgrep. Vous êtes à peu près sûr que c'est plus rapide. Mais de combien ? La différence est-elle réelle ou n'est-ce qu'un effet de cache lié au premier run ?
Vous avez optimisé une étape de build Docker. Vous pensez que c'est mieux. Mais vous ne l'avez chronométrée qu'une fois, avec time, qui vous donne un seul point de mesure et aucune statistique.
hyperfine répond correctement à ces questions.
Un premier benchmark
Comparons grep -r et git grep pour trouver tous les TODO d'un repository. Les deux sont déjà sur votre machine, et git grep ne cherche que dans les fichiers suivis par git :
hyperfine --warmup 3 'grep -r "TODO" .' 'git grep "TODO"'
Benchmark 1: grep -r "TODO" . (10 runs)
                mean     ±       σ          min     …     max
  Wall Time    321.4 ms  ±     7.0 ms     315.6 ms  …   335.2 ms
  Memory        11.5 MiB ±     0.0 MiB     11.5 MiB …    11.6 MiB

Benchmark 2: git grep "TODO" (29 runs)
                mean     ±       σ          min     …     max
  Wall Time    102.3 ms  ±     1.9 ms      99.7 ms  …   106.4 ms           -68.2%  (3.1x faster)
  Memory        31.8 MiB ±     0.8 MiB     29.6 MiB …    33.0 MiB         +176.1%  (2.8x more)
Moyenne, écart-type, min, max — pour le temps et la mémoire, sur autant de runs que nécessaire pour obtenir des chiffres stables. Chaque commande après la première est comparée à la première : ici git grep est 3,1 fois plus rapide, et utilise 2,8 fois plus de mémoire pour y arriver.
Installation
Avec Homebrew (macOS, Linux et WSL) :
brew install hyperfine
Avec cargo (toolchain Rust) :
cargo install hyperfine
Avec apt (Debian, Ubuntu) :
sudo apt install hyperfine
apt fournit hyperfine 1.x
Ubuntu 24.04 package la version 1.18 et Debian 13 la version 1.19. La version 2.0 a changé le format de sortie et la façon dont les commandes sont exécutées (voir Pas de shell par défaut), donc les exemples de cet article n'auront pas exactement la même allure. Pour obtenir la 2.0 sur Debian ou Ubuntu, installez le .deb attaché à la release GitHub :
curl -LO https://github.com/sharkdp/hyperfine/releases/download/v2.0.0/hyperfine-musl_2.0.0_amd64.deb
sudo apt install ./hyperfine-musl_2.0.0_amd64.deb
Vérification :
hyperfine --version
hyperfine 2.0.0
Les runs de warmup
Le premier run d'une commande est souvent plus lent : les caches disque sont froids, l'OS n'a rien préchargé. C'est ce qui rend peu fiables les outils à mesure unique comme time. hyperfine gère ça avec --warmup :
hyperfine --warmup 3 'grep -r "TODO" .' 'rg "TODO"'
Trois runs jetables avant le début de la mesure. Le benchmark ne chronomètre que l'état chaud — la condition qui compte en usage réel.
Contrôler le nombre de runs
Par défaut, hyperfine exécute chaque commande au moins 10 fois, et continue pendant au moins trois secondes — c'est pourquoi les commandes rapides obtiennent des centaines de runs. Vous pouvez surcharger ce comportement :
hyperfine --min-runs 20 'my-command'   # at least 20 runs
hyperfine --runs 5 'my-command'        # exactly 5 runs (faster, less accurate)
Pour les commandes lentes (builds Docker, compilation), utilisez moins de runs :
hyperfine --runs 3 'docker build -t myapp:v1 -f Dockerfile.v1 .'
Pas de shell par défaut
Depuis la version 2.0, hyperfine exécute chaque commande directement, sans shell intermédiaire. Cela retire le temps de démarrage du shell de la mesure, mais cela signifie aussi que la syntaxe shell — pipes, redirections, &&, ~ — n'est pas interprétée. hyperfine refuse une telle commande plutôt que de mesurer silencieusement la mauvaise chose :
$ hyperfine 'seq 100 | sort'
Error: Command 'seq 100 | sort' contains unquoted shell syntax ('|').
Explicitly choose how to execute it:
-S / --shell=default  Interpret shell syntax.
-N / --shell=none     Run directly, passing '|' as a literal argument.
Ajoutez -S pour exécuter la commande via sh, ou --shell bash / --shell zsh pour en choisir un. Vos alias et fonctions shell ne sont jamais disponibles, avec ou sans -S : hyperfine ne voit que de vrais exécutables.
Benchmarker avec des entrées variables
Utilisez des placeholders {var} combinés à --parameter-list. Le pipe ci-dessous nécessite un shell, d'où le -S :
hyperfine -S --parameter-list size 100,1000,10000

'seq {size} | sort'
Benchmark 1: seq 100 | sort (1870 runs)
                mean     ±       σ          min     …     max
  Wall Time    569.5 µs  ±   209.2 µs     393.0 µs  …  1907.6 µs
  Memory         1.7 MiB ±     0.1 MiB      1.6 MiB …     1.9 MiB

Benchmark 2: seq 1000 | sort (2920 runs)
                mean     ±       σ          min     …     max
  Wall Time    700.3 µs  ±   321.8 µs     396.0 µs  …  2185.2 µs           +23.0%
  Memory         2.1 MiB ±     0.2 MiB      1.9 MiB …     2.4 MiB          +21.6%

Benchmark 3: seq 10000 | sort (1949 runs)
                mean     ±       σ          min     …     max
  Wall Time   1081.8 µs  ±   336.0 µs     840.7 µs  …  2630.4 µs           +89.9%  (1.9x slower)
  Memory         2.6 MiB ±     0.1 MiB      2.4 MiB …     2.8 MiB          +52.4%  (1.5x more)
Cela lance trois benchmarks automatiquement et vous montre comment la performance évolue avec la taille de l'entrée. Pour des commandes aussi courtes, hyperfine affiche aussi un avertissement : en dessous de 5 ms, le temps de démarrage du shell pèse sur le résultat.
Préparation et nettoyage
Certains benchmarks ont besoin d'une étape de setup qui ne doit pas être mesurée — vider un cache, créer un fichier de test, réinitialiser un état. Utilisez --prepare :
hyperfine --prepare 'sync; echo 3 | sudo tee /proc/sys/vm/drop_caches'

'grep -r "function" /usr/lib/python3'
La commande --prepare est exécutée avant chaque run chronométré, sans faire partie du temps mesuré. Elle passe toujours par un shell, donc le ; et le pipe fonctionnent ici sans -S.
Exporter les résultats
Trois formats d'export sont les plus utiles :
Table Markdown (à coller directement dans un article de blog ou un README) :
hyperfine --export-markdown results.md 'find . -name "*.md"' 'grep -rl "TODO" .'
La table ne contient que la métrique principale — le wall time, sauf si vous en choisissez une autre avec --metrics :
| Command | Mean Wall Time [ms] | Change | Factor |
|:---|---:|---:|:---|
| `find . -name "*.md"` | 6.2 ± 0.2 |  |  |
| `grep -rl "TODO" .` | 33.9 ± 0.8 | +446.7% | (5.5x slower) |
CSV (pour les tableurs ou une analyse plus poussée, une colonne par métrique) :
hyperfine --export-csv results.csv 'command1' 'command2'
JSON (pour le scripting, avec chaque run individuel) :
hyperfine --export-json results.json 'command1' 'command2'
Exemples concrets
grep vs ripgrep — le battage est-il justifié ?
hyperfine --warmup 3

'grep -r "ERROR" /var/log'

'rg "ERROR" /var/log'
Deux stratégies de build Docker
Vous avez un Dockerfile monolithique et une version multi-stage. Laquelle build le plus vite à partir d'un cache froid ?
hyperfine --runs 3

'docker build --no-cache -t test:mono -f Dockerfile.mono .'

'docker build --no-cache -t test:multi -f Dockerfile.multi .'
Le flag --no-cache garantit que chaque run repart de zéro. Sans lui, le cache de layers de Docker rend le deuxième run quasi instantané, quelle que soit la stratégie.
Temps de démarrage du shell
Si vous optimisez votre ~/.zshrc (peut-être après avoir lu l'article sur les workflows ZSH modulaires), mesurez l'impact avant et après :
hyperfine --warmup 5

'zsh -i -c exit'

'bash -i -c exit'
Comparaison des alternatives à find
hyperfine --warmup 3

'find . -type f -name ".ts"'

'fd -t f -e ts'

'rg --files -g ".ts"'
fd est rarement installé par défaut : brew install fd, ou sudo apt install fd-find sur Debian et Ubuntu, où la commande s'appelle fdfind.
Cela compare trois outils sur 10 runs ou plus chacun — impossible à évaluer équitablement avec un chronomètre.
Interpréter la sortie
Les chiffres clés :
- Wall Time, moyenne ± σ : temps moyen et écart-type. Un σ élevé par rapport à la moyenne signifie que les résultats varient beaucoup — plus de runs ou un
--preparepour vider les caches aideraient. - min … max : le run le plus rapide et le plus lent. Un écart important suggère des interférences externes (autres processus, I/O).
- Memory : le pic mémoire utilisé par la commande. Pratique quand l'outil le plus rapide est aussi le plus gourmand.
- La colonne de comparaison : chaque benchmark après le premier est comparé au premier, en pourcentage et sous la forme « N.Nx faster » ou « slower ». C'est le chiffre que vous êtes venu chercher — mettez donc votre commande de référence en premier.
Faites confiance à la moyenne, pas au minimum
Certains outils de benchmark ne rapportent que le temps minimum (l'argument étant que le minimum est la « vraie » vitesse et que tout le reste est du bruit). hyperfine compare les moyennes parce qu'en pratique, les commandes tournent en conditions réelles — pas dans un isolement idéal. La moyenne, c'est ce que vos utilisateurs vivent.
Sous le capot (passez votre chemin si vous voulez juste l'utiliser)
hyperfine vs time
La commande intégrée time vous donne une mesure. C'est très bien pour une curiosité ponctuelle. hyperfine sert quand le résultat compte :
time | hyperfine | |
|---|---|---|
| Runs | 1 | 10+ (configurable) |
| Warmup | Non | Oui (--warmup) |
| Statistiques | Non | Moyenne, σ, min, max |
| Mémoire | Non | Pic mémoire, par défaut |
| Comparaison | Manuelle | Automatique (contre la première commande) |
| Export | Non | Markdown, CSV, JSON |
| Entrées variables | Non | Oui (--parameter-list) |
Si vous présentez un benchmark à une équipe, rédigez un article de blog ou prenez une décision basée sur des données de performance, utilisez hyperfine. Pour une vérification rapide au feeling, time suffit.
Conclusion
hyperfine rend les affirmations de performance testables. ripgrep est-il plus rapide que grep ? Votre étape de build refactorisée est-elle vraiment une amélioration ? L'alias eza que vous avez ajouté à la place de ls se remarque-t-il ? Ce sont des questions auxquelles hyperfine répond en quelques secondes, avec assez de rigueur statistique pour faire confiance au résultat.
Ajoutez-le à votre boîte à outils, à côté des outils que vous benchmarkez déjà, et arrêtez de deviner.
Articles liés



yq — Le processeur YAML que vous savez déjà utiliser
19 octobre 2026

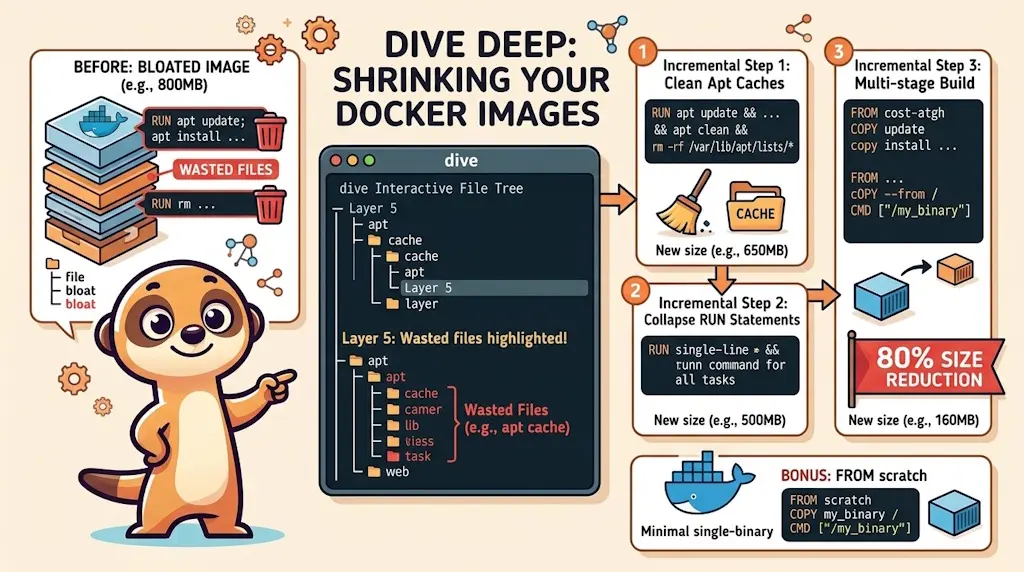
Docker Dive — Radiographiez vos images et éliminez le gaspillage
24 septembre 2026