Restaurer Marknotes avec Lovable.dev
Demander à Lovable.dev de créer une application dockerisée complète, avec un backend en Python/FastAPI et un frontend en React.


Traduction automatique
Cette semaine, un collègue m'a parlé de Lovable.dev en me disant : « Dans un prompt, tu décris simplement le programme que tu veux générer, et l'outil le construit et le déploie même pour toi ». Wow, il fallait vraiment que j'essaie.
Mais quoi demander ? Et si je lui demandais de créer un clone de Marknotes ? Ceux qui me suivent depuis des années savent que j'ai créé Marknotes, une application de prise de notes, il y a 10 ans. J'y ai travaillé pendant cinq ans avant de passer à autre chose.

Voyons si Lovable.dev peut construire la même chose en une heure seulement. Spoiler : non, mais ce n'était pas si mal.
Le résultat, après une heure et demie
Après quelques corrections (le parcours réel se trouve plus bas), l'application fonctionnait ! Je pouvais parcourir mon disque et afficher le contenu de mes fichiers Markdown.
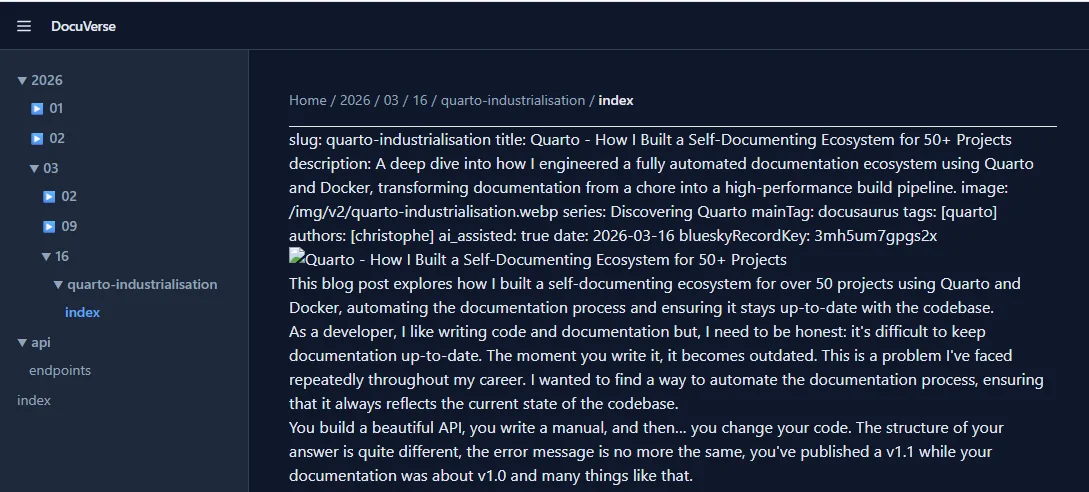
Comme vous le voyez, l'interface affiche la liste des fichiers à gauche et, quand je clique sur un fichier, le contenu est rendu à droite. L'application met aussi le HTML en cache dans Redis. Donc, si je reclique sur le même fichier, le contenu est récupéré depuis Redis et n'est pas régénéré.
Le rendu est loin d'être parfait, mais c'est un bon début. Je devrais peut-être préciser comment gérer le YAML front matter, les titres, etc. Cela reste une base très solide.
Comme demandé, j'ai un breadcrumb en haut de page pour afficher le chemin du fichier.
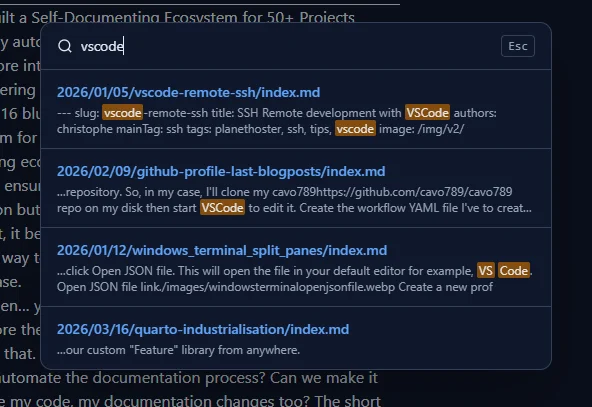
Dans le coin supérieur droit, il y a un moteur de recherche. En tapant vscode, j'obtiens une très belle liste des fichiers contenant ce mot. Quand je clique sur un fichier, son contenu est rendu à droite. Cette fonctionnalité est vraiment pratique : elle me permet de trouver rapidement un fichier sans devoir naviguer dans les dossiers.
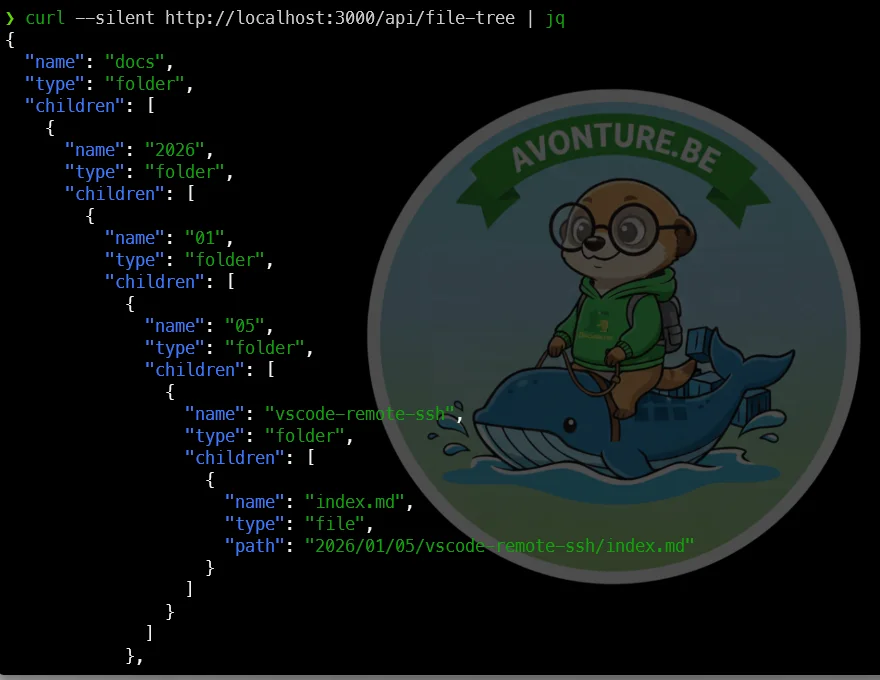
Autre très bon point : l'API fonctionne du premier coup. Je peux obtenir la liste des fichiers en appelant http://localhost:8000/api/file-tree et le contenu d'un fichier en appelant http://localhost:8000/api/render?path=path/to/file.md.
L'objectif
Je lui ai demandé de créer une application entièrement dockerisée avec un backend Python/FastAPI et un frontend React. L'application doit convertir le Markdown en HTML une seule fois. Si la conversion a déjà été faite, le HTML doit être servi depuis un cache (Redis). L'application doit pouvoir parcourir un dossier de mon disque de manière récursive et afficher la liste des fichiers et des dossiers. Quand je clique sur un fichier, elle doit convertir le contenu Markdown en HTML et l'afficher.
L'application doit aussi disposer d'un moteur de recherche pour rechercher du texte dans les fichiers Markdown (Meilisearch).
Voici le prompt que j'ai utilisé :
**Project Name:** DocuVerse
**Project Goal:**Create a high-performance, containerized, on-the-fly Markdown documentation server. The application will serve a beautiful, responsive, and feature-rich web interface to browse and read Markdown files from a read-only directory. The architecture must be decoupled into a Python/FastAPI backend, a React/Next.js frontend, a Redis cache, and a Meilisearch engine for powerful search capabilities, all orchestrated via Docker Compose.
### **1. High-Level Architecture & Services**
The application will consist of four distinct services running in Docker containers:
1. **`backend` (Python/FastAPI):** The core API. It handles file system scanning, Markdown-to-HTML conversion, caching logic with Redis, and indexing/searching with Meilisearch.2. **`frontend` (Next.js/React):** The user-facing web application. It consumes the backend API to display the file structure, rendered content, and search results. It must be styled with **Tailwind CSS**.3. **`redis` (Official Image):** A high-speed in-memory cache to store the generated HTML, avoiding redundant Markdown parsing.4. **`meilisearch` (Official Image):** A powerful search engine to provide instant, fuzzy, and typo-tolerant search across all documentation files.
### **2. Detailed Backend Specification (`backend` service)**
* **Framework:** **Python 3.11** with **FastAPI**.* **Markdown Parsing:** Use the `markdown-it-py` library. It must be configured with plugins for: * Syntax highlighting for code blocks (e.g., using `pygments`). * Automatic anchor links for headings (`<h2>`, `<h3>`, etc.).* **Caching Strategy:** 1. When a request for a file arrives, the backend MUST read the raw content of the `.md` file. 2. It MUST compute a **SHA256 hash** of the file's content. 3. It MUST query Redis using the hash as the key (e.g., `GET doc-sha256:<hash>`). 4. **Cache Hit:** If Redis returns HTML, serve it immediately. 5. **Cache Miss:** If Redis returns `nil`, parse the Markdown to HTML, store the result in Redis (`SET doc-sha256:<hash> <html_content>`), and then serve it.* **Search Integration (Meilisearch):** * **On Startup:** The backend MUST recursively scan the entire `/docs` directory. For each `.md` file found, it must read its content, strip the Markdown to plain text, and send it to a Meilisearch index named `docs`. Each document in Meilisearch should have at least two fields: `filePath` (e.g., `getting-started/installation.md`) and `content`.* **API Endpoints:** * `GET /api/file-tree`: Returns a JSON object representing the recursive directory structure of the `/docs` volume. Exclude non-Markdown files. * *Example Response:* `{ "name": "docs", "type": "folder", "children": [ { "name": "guide.md", "type": "file", "path": "guide.md" }, { "name": "api", "type": "folder", "children": [...] } ] }` * `GET /api/render/{file_path:path}`: Renders a specific Markdown file. * It implements the caching logic described above. * The response must be a JSON object containing the rendered HTML and a Table of Contents structure. * *Example Response:* `{ "htmlContent": "<h1>Title</h1>...", "toc": [{ "level": 1, "text": "Title", "id": "title" }, { "level": 2, "text": "Subtitle", "id": "subtitle" }] }` * `POST /api/search`: Performs a search query against Meilisearch. * *Request Body:* `{ "query": "fuzzy search boolean" }` * *Response:* A JSON array of results, including the file path and a content snippet (highlighting the match). `[ { "filePath": "...", "snippet": "..." } ]`* **Static Files:** The backend must be able to serve images or other assets referenced in the Markdown files from the `/docs` directory. Create an endpoint like `GET /api/assets/{file_path:path}`.
### **3. Detailed Frontend Specification (`frontend` service)**
* **Framework:** **Next.js** with **React** and **TypeScript**.* **Styling:** **Tailwind CSS**. The UI must be clean, modern, and prioritize content readability.* **Layout (Three-column design):** 1. **Left Sidebar (File Explorer):** Displays the file tree fetched from `/api/file-tree`. It should be collapsible. 2. **Center Column (Content):** Displays the `htmlContent` returned by `/api/render`. This area should take up the maximum available space. 3. **Right Sidebar (Table of Contents):** Displays the active page's ToC, generated from the `toc` object from the API. It should highlight the current section as the user scrolls.* **Persistent UI Elements:** * **Header:** A slim header at the top, always visible. It contains the **Search Bar** and a **Dark/Light Mode toggle**. * **Breadcrumbs:** Located just above the content, showing the path to the current file (e.g., `Home > API Reference > Endpoints`).* **Core Features:** * **Dark/Light Mode:** Must respect the user's OS preference (`prefers-color-scheme`) by default but be overridable with the toggle. Use Tailwind's `dark:` variant. * **Search UI:** The search bar in the header should trigger a call to `/api/search`. Results should be displayed in a clean overlay or dropdown. Clicking a result navigates to that page. The search must support fuzzy search and boolean operators as provided by Meilisearch. * **Code Blocks:** All code blocks (`<pre><code>`) must have: * Excellent syntax highlighting (use `highlight.js` or a similar library). * A "Copy to Clipboard" button that appears on the top-right corner on hover. * **Printing:** The application must have a print-specific stylesheet (`@media print`). When a user hits CTRL+P, the printed output MUST be a clean, perfectly formatted document containing only the main content (no sidebars, headers, etc.).* **Customization:** * The application must load an optional `/config/custom.css` file if it exists. This allows users to override the default styles.
### **4. Containerization & Deployment**
* **`Dockerfile` for `backend`:** Must be a **multi-stage build** to keep the final image size small. Use Poetry for dependency management.* **`Dockerfile` for `frontend`:** Must also be a **multi-stage build**, compiling the Next.js app into an optimized production server.* **`compose.yaml`:** * Define all four services (`backend`, `frontend`, `redis`, `meilisearch`). * Configure service dependencies (`backend` depends on `redis` and `meilisearch`). * **Volumes:** * Mount the user's documentation folder as a read-only volume: `- ./my-docs:/docs:ro`. * Mount an optional config folder: `- ./config:/config:rw`. * Use named volumes for Redis (`redis_data`) and Meilisearch (`meili_data`) data persistence. * Expose frontend on port `3000` and Meilisearch on `7700`.
### **Summary of Instructions:**
Generate the complete, ready-to-use source code for this "DocuVerse" application. This includes:1. The full Python/FastAPI backend project structure.2. The full Next.js/React/Tailwind CSS frontend project structure.3. A root-level `compose.yaml` file to orchestrate all services.4. Optimized, multi-stage `Dockerfile` for both the backend and frontend.
Please ensure the code is clean, well-commented, and follows modern best practices. The generated application should be runnable with a single `docker compose up` command after placing Markdown files in a `my-docs` directory.DocuVerse est un serveur de documentation Markdown haute performance composé de quatre services Docker : un backend FastAPI qui analyse les fichiers Markdown, les cache avec Redis et les indexe avec Meilisearch, un frontend Next.js/React qui affiche l'interface utilisateur avec un design trois colonnes, et les services Redis et Meilisearch pour la performance et la recherche. L'application scanne un répertoire de documentation en lecture seule et fournit une navigation fluide avec recherche, cache intelligent et support du mode sombre.
Le chemin parcouru : versions successives et erreurs
Après une minute, j'avais une première version de l'application. Comme je voulais utiliser exclusivement Docker, la commande à lancer était docker compose up --build.
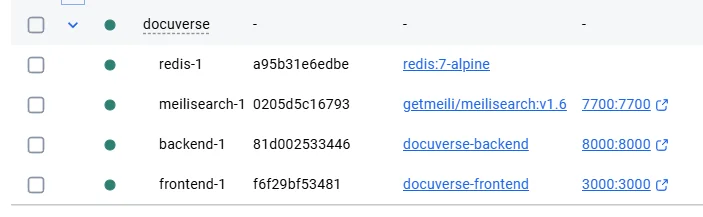
Ça ne fonctionnait pas, à cause d'une erreur dans le Dockerfile du frontend. J'ai copié/collé l'erreur dans le prompt et j'ai obtenu une deuxième version. Puis une troisième, une quatrième et enfin une cinquième.
La dernière s'est buildée correctement. J'avais l'interface web avec deux fichiers Markdown d'exemple, mais aucun ne s'affichait à cause d'une erreur Python.
J'ai copié/collé l'erreur dans le prompt et j'ai reçu une réponse du type : « Ok, l'erreur se situe dans le fichier ... et tu dois faire cette modification et celle-là. »
Conclusion
Après environ deux heures, tout fonctionnait. Je pouvais parcourir mon disque, afficher le contenu des fichiers Markdown et rechercher du texte dans les fichiers.
Comme l'IA a vraiment participé à la rédaction de cet article (et à cette application), il porte le badge « AI Assisted » — voyez comment j'indique le contenu assisté par IA dans Docusaurus si vous voulez savoir comment ça marche.
Comme je dispose du code source complet, je peux continuer à l'améliorer moi-même, demander à Lovable.dev de le faire pour moi, ou envoyer le code sur une autre plateforme IA (comme Google AI Studio).
Si vous voulez l'essayer, vous pouvez le télécharger en cliquant sur le bouton ci-dessous.
TéléchargerChargement des commentaires…