Pandas - Fusionner deux fichiers ou plus et en créer un seul
Fusionnez efficacement deux fichiers CSV ou Excel (ou plus) en Python grâce à la puissante librairie Pandas. Apprenez pas à pas à gérer les enregistrements manquants et à consolider des données comme les salaires des employés sur plusieurs années dans un seul DataFrame propre.

Traduction automatique
Journal des modifications
Cet article montre comment utiliser la librairie Pandas de Python pour fusionner plusieurs fichiers CSV annuels (par exemple les salaires des employés de 2020 à 2024) en un seul fichier consolidé, en gérant correctement les enregistrements qui n'apparaissent pas dans chaque fichier (nouvelles embauches, départs) — une tâche qui devient ingérable dans Excel avec VLOOKUP dès que les fichiers dépassent quelques rows.
Vous avez deux fichiers ou plus et vous souhaitez les fusionner. Par exemple, une liste d'employés et leur salaire de 2020 à 2024. Ou une liste de centres de coûts avec leur budget/dépenses. Ou une liste d'étudiants et leurs notes. Ou ...
Prenons un exemple : une liste d'employés et leurs salaires.
Nous avons plusieurs fichiers, un par année, avec cette structure :
id;first_name;last_name;salary
0;Gina;Andrade;6040
1;Adam;Rowe;3866
2;Michael;Martinez;6913
Et notre besoin est de fusionner les fichiers annuels pour en générer un seul avec les employés et leur salaire au fil des années. Au final, nous voulons obtenir ceci :
id;first_name;last_name;salary_2020;salary_2021;salary_2022;salary_2023;salary_2024
0;Gina;Andrade;6040;4413;7773;6208;7363
1;Adam;Rowe;3866;3678;2726;5425;7570
2;Michael;Martinez;6913;6493;5664;4902;4657
Avec Pandas, ce sera un jeu d'enfant...
Le résultat : cinq années de salaires, un seul fichier
Lancer le script de fusion (présenté en entier plus bas) sur cinq fichiers CSV annuels produit un fichier consolidé, y compris pour les employés arrivés ou partis en cours de route :
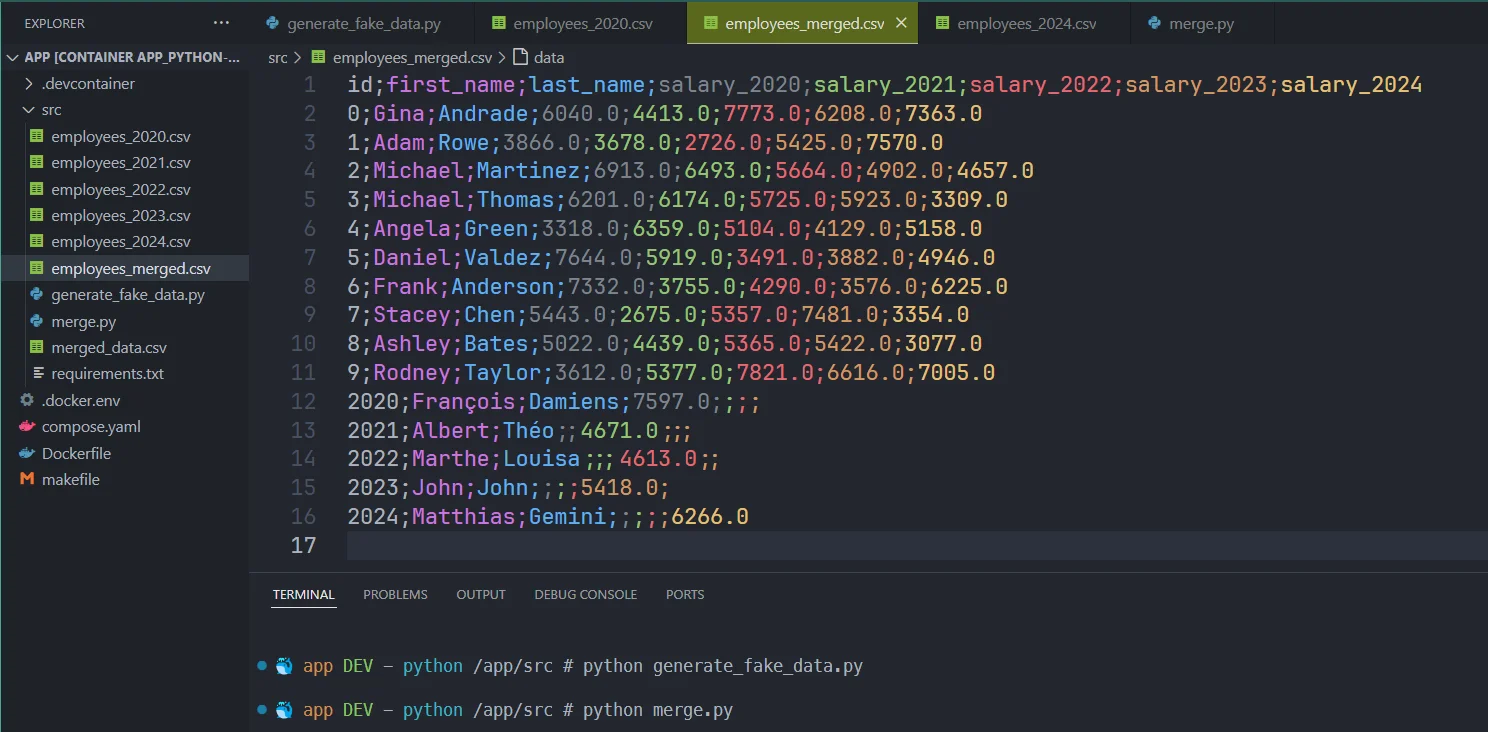
Comme on le voit sur l'image, la fusion est bien là : nos 10 employés (de 0 à 9), et si un employé était présent dans un fichier (comme celui ajouté en 2023, appelé John John), on voit son salaire dans le résultat.
Et, ouvert dans Excel, voici notre résultat final (et si vous devez coller ce résultat dans un document Markdown, mon convertisseur CSV to Markdown table le fait en un clic) :
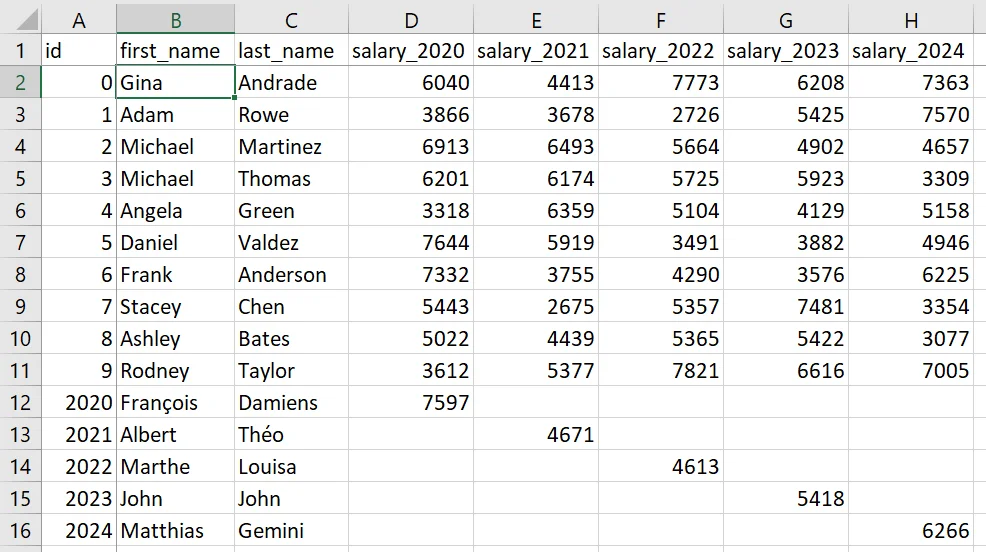
L'année prochaine, nous aurons un fichier appelé employees_2025.csv et il suffira de relancer la fusion.
Pourquoi ça fonctionne
Remarque
Rien ne garantit qu'un employé se trouve dans chacun des fichiers. Il peut être présent en 2020 et 2021 puis quitter l'entreprise ; il peut être engagé en 2022 et démissionner en 2023 ; il peut n'arriver qu'en 2024.
La fusion doit donc en tenir compte.
- La fusion utilise un outer join sur
id, donc personne n'est écarté silencieusement, qu'il soit arrivé en cours de période ou parti avant le dernier fichier. - Chaque colonne
salaryannuelle est renomméesalary_2020,salary_2021, ... avant la fusion, ainsi les colonnes n'entrent jamais en collision. - Aucune formule
VLOOKUPà maintenir entre les feuilles, et aucune row d'appoint à ajouter à la main quand quelqu'un manque pour une année.
Installation
Pour illustrer cet article, créons quelques fichiers CSV. Nous allons créer des fichiers de 2020 à 2024. Passez ce chapitre si vous avez déjà vos propres fichiers CSV.
Nous allons créer un ensemble de 10 employés qui resteront avec nous tout du long et, pour chaque année, nous créerons un employé présent uniquement cette année-là. Ceci pour illustrer le fait qu'un employé peut figurer dans un fichier et pas dans les autres.
Le script ci-dessous va créer deux fichiers, un appelé employees_2023.csv et un pour employees_2024.csv, afin d'avoir des fichiers factices.
Remarque
Pour pouvoir lancer ce script, vous devez d'abord exécuter pip install pandas faker pour installer les deux packages.
# cspell:disable
def generate_fake_data(filename: str = "employees") -> None: fake = Faker()
max: int = 10
employees: dict = []
for id in range(max): employee = { "id" : id, "first_name": fake.first_name(), "last_name": fake.last_name(), }
employees.append(employee)
extra_employees: dict = { 2020: ("François", "Damiens"), 2021: ("Albert", "Théo"), 2022: ("Marthe", "Louisa"), 2023: ("John", "John"), 2024: ("Matthias", "Gemini") }
for year in { 2020, 2021, 2022, 2023, 2024 }: salaries: dict = []
for id in range(max+1):
if id == max: id = year firstname, lastname = extra_employees[id] else: firstname = employees[id]["first_name"] lastname = employees[id]["last_name"]
salary = { "id": id, "first_name": firstname, "last_name": lastname, "salary": int(fake.random.randint(2500, 8000)) }
salaries.append(salary)
df = pd.DataFrame(salaries)
df.to_csv(f"{filename}_{year}.csv", index=False, encoding="utf-8", sep=";")
generate_fake_data("employees")Cette fonction génère des données d'employés fictives et les sauvegarde dans des fichiers CSV séparés par année. Elle crée d'abord une liste de 10 employés avec des noms générés aléatoirement, puis pour chaque année de 2020 à 2024, elle construit un fichier CSV contenant les salaires de ces employés plus un employé supplémentaire spécifique à cette année.
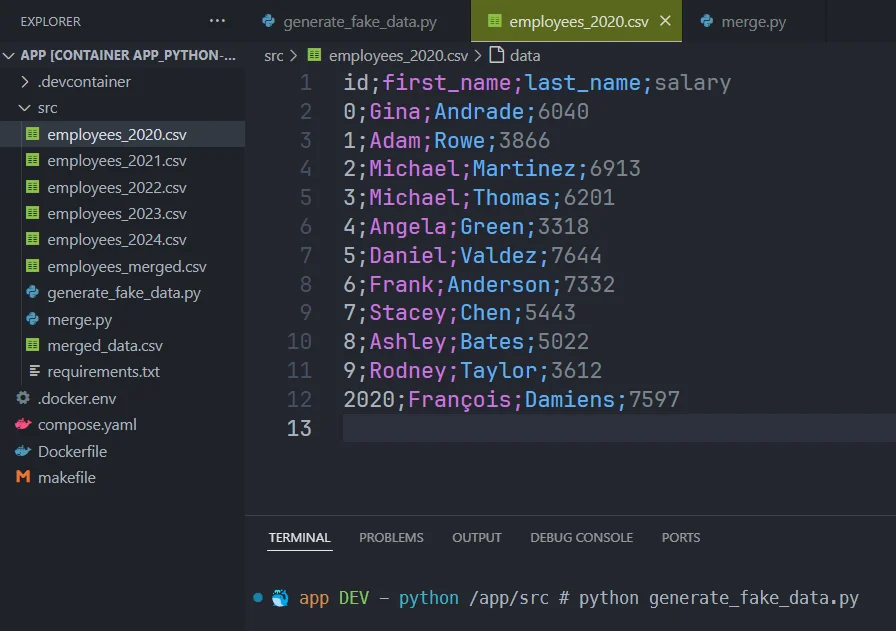
En lançant ce script, nous obtenons quelques fichiers csv ayant exactement la même structure, comme ceci :
id;first_name;last_name;salary
0;Gina;Andrade;6040
1;Adam;Rowe;3866
2;Michael;Martinez;6913
3;Michael;Thomas;6201
4;Angela;Green;3318
Plus de démos : le script de fusion, ligne par ligne
Avec Pandas, il est assez simple de boucler sur les fichiers et de faire une fusion.
def merge_data(filename: str = "employees") -> None: # Initialize the merged DataFrame with the first year's data merged_df: pd.DataFrame = pd.read_csv(f"{filename}_2020.csv", sep=";") merged_df.rename(columns={'salary': 'salary_2020'}, inplace=True)
# Iterate over remaining years and merge for year in range(2021, 2025): df_year = pd.read_csv(f"{filename}_{year}.csv", sep=";")
# So, for the first run, rename column "salary" as "salary_2021" df_year.rename(columns={'salary': f'salary_{year}'}, inplace=True)
# And merge both: for the first run, we'll retrieve all columns from files 2020 and append # the salary of 2021. And do the same across years merged_df = merged_df.merge(df_year, on=['id', 'first_name', 'last_name'], how='outer')
# Save the merged DataFrame to a new CSV file merged_df.to_csv(f"{filename}_merged.csv", index=False, encoding="utf-8", sep=";")
merge_data("employees")Cette fonction charge des fichiers CSV contenant des données d'employés pour différentes années, renomme la colonne salary en salary_YYYY pour chaque année, puis les fusionne tous ensemble sur les colonnes id, first_name et last_name. Le résultat final est sauvegardé dans un nouveau fichier CSV contenant toutes les salaires côte à côte par année.
Le script va prendre le premier fichier (employees_2020.csv) et le charger en mémoire. La colonne salary sera, en mémoire, renommée salary_2020.
Ensuite, pour chaque année restante (de 2021 à 2024), le script va charger un deuxième fichier et le fusionner avec le précédent (donc, d'abord, fusionner 2020 et 2021).
L'action de fusion signifie : récupérer id, first_name et last_name puis aussi salary_2020 du premier fichier et salary_2021 du deuxième, et créer un nouveau fichier (un DataFrame dans le vocabulaire de Pandas).
Puis traiter les fichiers restants (2022 à 2024).
À la fin, le script sauvegarde le fichier sur le disque sous le nom employees_merged.csv.
Sous le capot (passez cette section si vous voulez juste l'utiliser)
Pourquoi outer et pas inner ou left
merged_df.merge(df_year, on=['id', 'first_name', 'last_name'], how='outer') fait tout le travail. L'argument how décide qui survit à la fusion :
innerne garderait que les rows dont l'idexiste dans chaque fichier fusionné jusque-là — toute personne arrivée après 2020 ou partie avant 2024 disparaît.leftne garderait que les rows du premier fichier — les nouvelles embauches des années suivantes n'apparaîtraient jamais.outer(utilisé ici) garde l'union : chaqueidvu dans n'importe quel fichier, avecNaNpour les années où la personne n'avait pas de row.
Pourquoi les colonnes n'entrent pas en collision
Le comportement par défaut de Pandas, quand une fusion trouve le même nom de colonne (salary) des deux côtés, est de les suffixer salary_x / salary_y — acceptable pour deux fichiers, illisible pour cinq. C'est pourquoi le script renomme salary en salary_{year} avant chaque fusion : au moment où merge() s'exécute, les noms de colonnes sont déjà uniques, donc le résultat affiche salary_2020, salary_2021, ... au lieu d'un empilement de _x/_y/_x_x.
Conclusion
Sans Pandas, l'approche habituelle consiste à charger les fichiers un par un dans Excel, à créer des formules comme vlookup entre chaque sheet, et à créer une nouvelle sheet qui contiendra les valeurs trouvées — mais cela ne fonctionne que si le même enregistrement se trouve dans plusieurs fichiers.
Comment gérez-vous les cas où un enregistrement a été ajouté ? Il faudrait faire un append dans la sheet qui fusionne tout et ... Une solution serait d'ajouter tous les enregistrements dans une feuille globale (avec une colonne année) puis d'utiliser un tableau croisé dynamique pour ... aïe, ça complique les choses, non ?
Maintenant, imaginons des fichiers CSV qui ne font pas 10 rows mais plus d'un million de rows chacun. Charger 5 fichiers (2020 à 2024), c'est charger plus de 5 millions de rows et avoir une sheet qui contiendra la fusion et au moins 1 million de rows elle aussi.
Imaginez l'effort pour ouvrir les fichiers et attendre qu'Excel recalcule ses formules. L'horreur !
À cette échelle, la vraie réponse est généralement d'arrêter de jongler avec des fichiers et de mettre les données dans une base de données, puis de laisser Excel l'interroger ; voyez MS Excel - Se connecter à une base de données SQL Server, exécuter une requête et récupérer les résultats.