Quarto - Comment j'ai construit un écosystème auto-documenté pour plus de 50 projets
Plongée dans la conception d'un écosystème de documentation entièrement automatisé avec Quarto et Docker, transformant la documentation en un pipeline de build performant.


Traduction automatique
Cet article fait partie de la série Découvrir Quarto :
- Exécuter Quarto Markdown dans Docker
- Affichage conditionnel avec Quarto
- Utiliser Quarto pour créer un diaporama PowerPoint
- Utiliser des variables depuis un fichier externe dans votre projet Quarto
- Quelques astuces pour Quarto lors du rendu en diaporama reveal.js
- Les blocs Callout de Quarto
- Le short code includes de Quarto
- Style inline avec Quarto
- Mes extensions Quarto préférées
- Utiliser le templating Mustache avec Quarto
- Rendez votre projet Quarto prêt pour les Devcontainers — fini les galères de configuration
- Quarto - Comment j'ai construit un écosystème auto-documenté pour plus de 50 projets
Cet article explique comment j'ai construit un écosystème auto-documenté pour plus de 50 projets avec Quarto et Docker : la documentation est automatisée et reste alignée avec le code.
En tant que développeur, j'aime écrire du code et de la documentation, mais soyons honnêtes : garder une documentation à jour est difficile. À la seconde où vous l'écrivez, elle devient obsolète. C'est un problème que j'ai rencontré encore et encore au cours de ma carrière. Je voulais trouver un moyen d'automatiser la documentation, pour qu'elle reflète toujours l'état réel du code.
Vous construisez une belle API, vous écrivez un manuel, puis… vous modifiez votre code. La structure de la réponse n'est plus la même, le message d'erreur a changé, vous avez publié une v1.1 alors que votre documentation parlait encore de la v1.0, et ainsi de suite.
Que faire pour résoudre ce problème ? Peut-on automatiser la documentation ? Peut-on la rendre auto-actualisante ? Peut-on faire en sorte que ma documentation change quand mon code change ? Réponse courte : oui. Et c'est exactement ce que j'ai fait avec Quarto.
Voyons comment industrialiser notre documentation avec Quarto et Docker, en créant un écosystème auto-documenté qui passe à l'échelle sur plusieurs projets.
🚀 Le moment « Wow »
Une fois le labo en route (voir la section Installation plus bas), ouvrez le dossier dans VS Code, cliquez sur "Reopen in Container", puis tapez dans le terminal : ./scripts/preview.sh.
Vous obtiendrez quelque chose comme ceci :
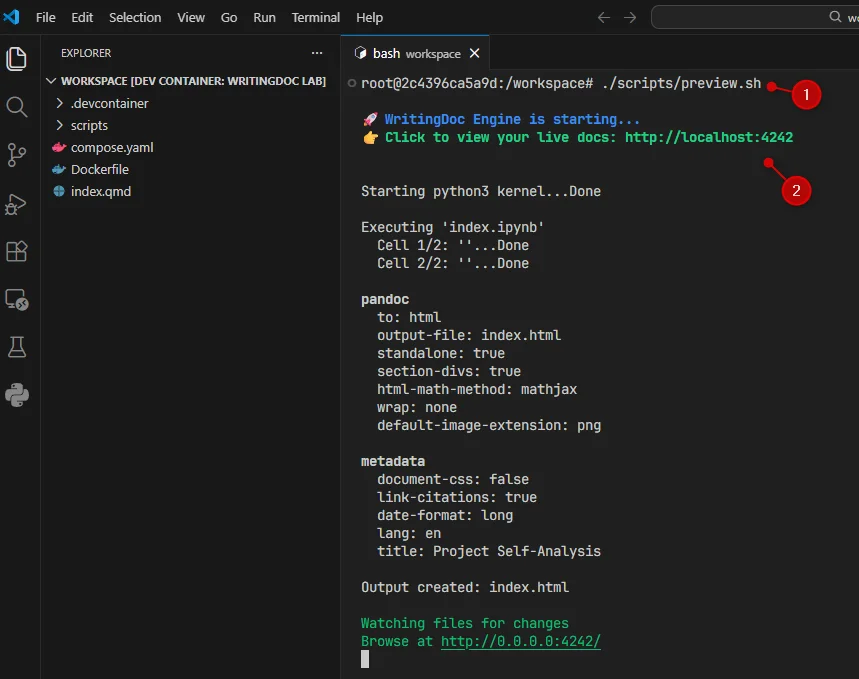
Faites un Ctrl + Click sur l'URL (http://localhost:4242) : votre navigateur s'ouvre avec le document Quarto rendu. Vous devriez voir les diagrammes Mermaid générés par nos scripts Python.
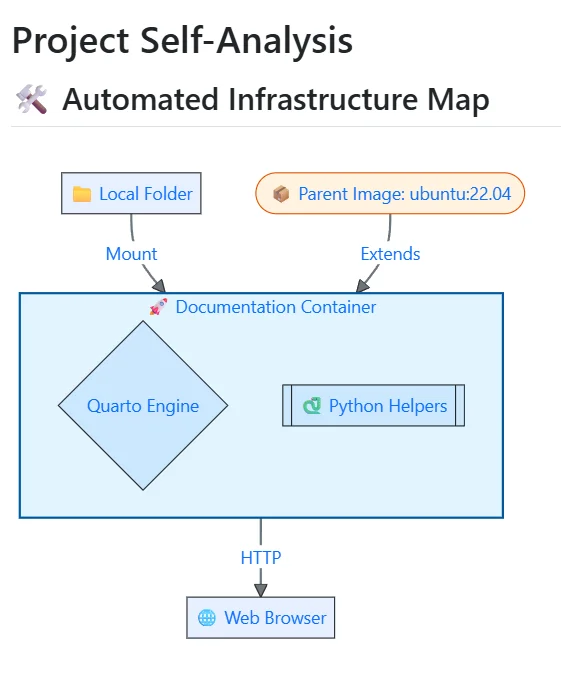
Sympa, non ? Mais d'où vient ce diagramme ? Il est généré par la fonction render_project_arch() de notre script project_viz.py. Ce script lit notre compose.yaml et notre Dockerfile pour comprendre la structure du projet, puis génère un diagramme Mermaid à partir de ça.
Regardons la sortie de notre script file_stats.py. Il analyse les fichiers du projet et produit un rapport rendu directement dans le document Quarto.
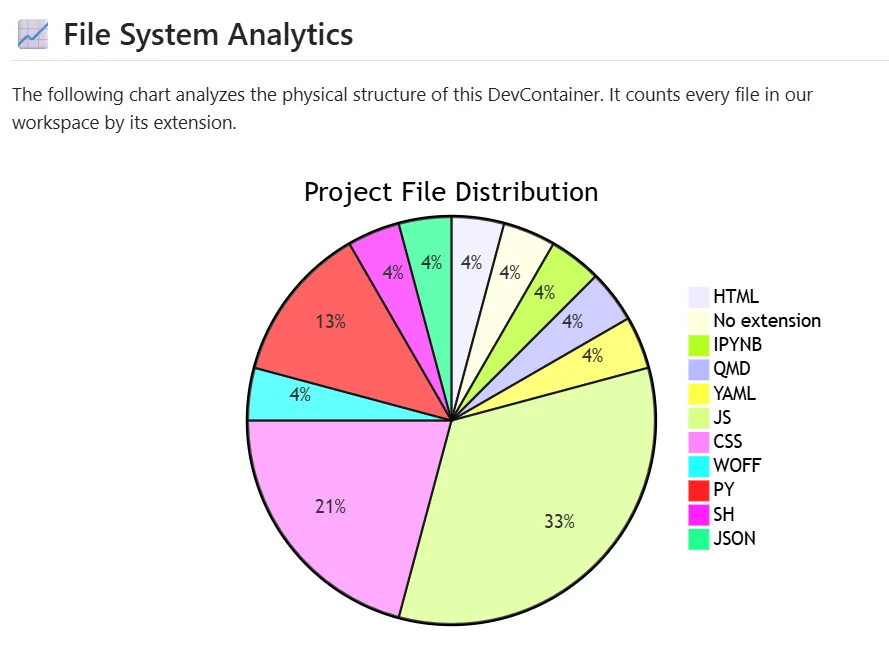
Et c'est en temps réel. Ajoutez un nouveau fichier au projet, sauvegardez, rafraîchissez le navigateur : le fichier apparaît dans les stats et le diagramme d'architecture se met à jour.
Le script my_feature.py génère un diagramme Mermaid simple à partir d'une liste d'éléments. Modifiez la liste dans le script, sauvegardez, et voyez le diagramme se mettre à jour en direct.

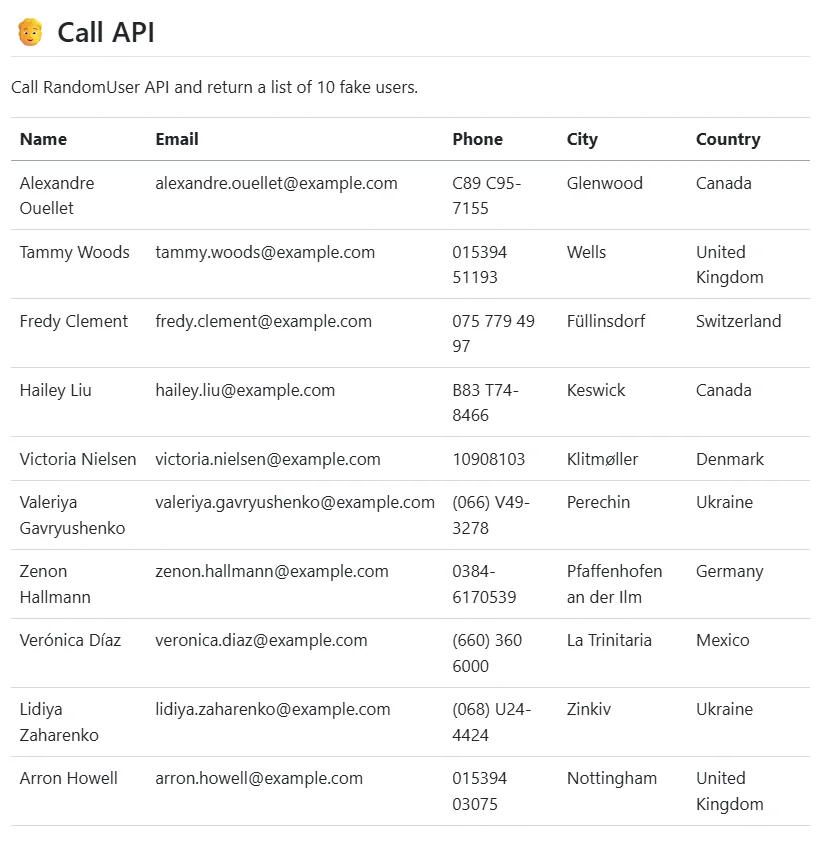
Enfin, le script call_api.py permet d'appeler une API en direct pendant le rendu. Vous pouvez donc récupérer de vraies données de votre environnement de production ou de staging et les inclure dans votre documentation, tout en gardant vos identifiants à l'abri grâce au Secrets Resolver.
Pourquoi ça fonctionne
Beaucoup pensent que le Doc-as-Code, c'est juste « mettre du Markdown dans Git ». Faux. Il s'agit d'exécution au runtime.
- Un document Quarto n'est pas du Markdown statique : un bloc de code
{python}intégré au document s'exécute pendant le rendu, pas avant. output: asisdit à Quarto de traiter ce que la fonction Python affiche comme du Markdown brut (ou du Mermaid) plutôt que comme du texte littéral — une fonction qui retourne un diagramme devient donc un diagramme rendu, pas un listing de code.- Comme le diagramme est généré à partir du
compose.yamlet duDockerfileréels, modifier l'infrastructure puis relancer le rendu met à jour le diagramme automatiquement — plus jamais de redessin manuel.
Installation — Le labo « Wow » : construisez votre premier moteur de doc en 5 minutes
Voici une configuration concrète, prête à l'emploi. Ce Dockerfile crée un environnement où Quarto peut « discuter » avec des scripts Python personnalisés pour générer des diagrammes Mermaid à la volée. La partie Python-vers-Mermaid est détaillée à part dans Documentation as Code - Transformez votre infrastructure en diagrammes soignés avec Python et Mermaid ; ici, on la branche sur Quarto.
1. L'orchestrateur (compose.yaml)
2. Le moteur (Dockerfile)
On installe Quarto et on configure le PYTHONPATH pour que notre document puisse importer notre bibliothèque « Feature » maison depuis n'importe où.
3. L'expérience (.devcontainer/devcontainer.json)
C'est ici que la magie opère. On indique à VS Code quelles extensions installer et comment se comporter. Rendez votre projet Quarto prêt pour les Devcontainers — fini les galères de configuration parcourt ce fichier ligne par ligne.
4. Nos scripts Python
On va utiliser quelques scripts Python simples pour générer le contenu de la documentation. Par exemple, my_feature.py contient une fonction qui génère un diagramme Mermaid à partir d'une liste d'éléments, file_stats.py analyse les fichiers du projet et produit un rapport, et project_viz.py crée une représentation visuelle de la structure du projet.
5. Le document (index.qmd)
C'est ici qu'on écrit notre document Quarto. Au lieu de Markdown statique, on peut exécuter du code Python directement dans le document pour générer du contenu dynamique. Par exemple, on peut appeler notre script my_feature.py pour générer un diagramme Mermaid basé sur l'état actuel du code.
Vous voyez les trois blocs {python} dans le document ? C'est là que la magie opère. C'est là qu'on exécute notre code Python. La sortie de ce code est rendue directement dans le document.
Quand Quarto rencontre le bloc ci-dessous, il exécute la fonction render_project_arch() de notre script project_viz.py (cette feature doit être présente dans le PYTHONPATH). La fonction génère un diagramme Mermaid basé sur l'état actuel du projet, et Quarto le rend directement dans le document.
```{python}
#| echo: false
#| output: asis
from project_viz import render_project_arch
render_project_arch()
```
L'option output: asis dit à Quarto de traiter la sortie comme du Markdown brut. Autrement dit, si notre script Python sort un diagramme Mermaid, Quarto le rend comme un diagramme au lieu d'afficher simplement le code.
Le projet complet
Voici la structure complète du projet. Vous pouvez copier cette configuration et la lancer sur votre machine pour voir comment ça marche en pratique. Le plus simple : cliquez sur le bouton Generate install script puis sur le bouton Copy. Ouvrez un terminal et collez la commande. Elle créera un dossier /tmp/quarto_industrialisation avec tous les fichiers et le setup Docker prêt à l'emploi.
Besoin d'aide ? Cliquez sur le bouton « Aide » ci-dessus pour les instructions de mise en place.
Mon cas d'usage réel
Dans mon écosystème de 50 projets, j'ai repris ce concept de « labo » pour en faire une image de base WritingDoc de qualité industrielle.
La plupart des setups de documentation partent d'une image « minimale ». C'est une erreur. « Minimal » veut dire « démarrage lent ». J'ai fait l'inverse. Mon image est un monstre de 2,5 Go, mais elle suit une philosophie « Zero-Wait ».
J'ai tout intégré dedans : Quarto, Python, Node.js, Mermaid-CLI, et tous les linters imaginables. Quand un rédacteur ouvre un projet dans un DevContainer VS Code, il n'attend ni apt-get ni pip install. L'environnement est vivant et prêt dès l'ouverture de la fenêtre. Pour la version accessible aux débutants de cette idée, voyez Rendez votre projet Quarto Devcontainer-Ready — cet écosystème, c'est le même principe poussé à 50 projets.
Doc-as-Code : la magie de l'AST Python
Le vrai facteur « Wow » a commencé quand j'ai arrêté de copier-coller du code dans du Markdown. J'ai écrit une suite de « Features » Python qui utilisent l'analyse AST (Abstract Syntax Tree) pour lire mon code source.
En réalité, j'ai plus de 40 « Features » différentes capables d'analyser mon code, d'en extraire des informations et de générer de la documentation automatiquement.
Quelques exemples de ces features :
🧠 Analyseurs sémantiques AST Python
🗄️ Introspection de base de données en direct
🎨 Moteur Mermaid conscient du format
🔐 Orchestrateur d'API authentifiées sécurisé
env:) pour que les identifiants ne touchent jamais Git.🖥️ Capture de terminal haute fidélité
⚙️ Cartographe d'infrastructure GitLab CI/CD
includes et extends récursifs. Génère une architecture visuelle des étapes CI/CD avec des descriptions de jobs lisibles.🐳 Visualiseurs d'écosystème Docker
📋 Tableau de bord des TODO « invisibles »
<!-- TODO: -->) dans tout le projet pour générer un backlog interne consolidé — invisible dans l'export PDF ou Word final destiné au client.✨ Assistant de workspace dynamique
📊 Visualiseur de données multi-formats intelligent
🏗️ Générateur de projet conscient du langage
file.python.fastapi.qmd) pour générer instantanément une structure de documentation complète et adaptée aux technologies du projet.Visualiser l'invisible : Mermaid & cache
Quarto sait rendre Mermaid.js quand la documentation est produite sous forme de site web, mais ça ne fonctionne pas pour les sorties hors ligne comme Word ou PDF.
J'ai résolu ça en construisant un Advanced Mermaid Renderer. Chez moi, le moteur de rendu est conscient du format. Si vous consultez la prévisualisation HTML, il sert des SVG nets. Si vous générez un .docx pour un décideur métier, il démarre automatiquement une instance Chromium headless (via Puppeteer), rend le diagramme à 300 DPI et intègre un PNG haute résolution.
Et comme je déteste attendre, j'ai implémenté un système de cache basé sur le contenu. Chaque diagramme et chaque snapshot d'API a son empreinte. Si la source n'a pas changé, le build saute le gros du travail et récupère l'image depuis le cache. Mes temps de build sont passés de plusieurs minutes à quelques secondes.
La documentation « vivante » : appels d'API authentifiés
Je voulais que ma documentation soit une fenêtre sur le système en production. J'ai donc construit une feature capable d'effectuer de vrais appels d'API REST pendant le rendu.
Elle gère tout le handshake OAuth2 : elle interroge le serveur d'authentification, obtient un token Bearer, récupère les dernières données et masque les secrets avant d'afficher une « trace terminal » dans la documentation.
Inquiet pour la sécurité ? J'ai écrit un Secrets Resolver maison. En utilisant un préfixe env: dans mes fichiers Quarto, je peux récupérer des identifiants depuis un fichier .secrets local qui n'est jamais commité dans Git. Le framework les résout au runtime et les masque dans tous les fichiers de log. De la sécurité de niveau entreprise pour du Markdown.
L'assistant « invisible » : daemons en arrière-plan & snippets
Je me suis rendu compte que, malgré toute cette automatisation, les rédacteurs devaient encore se souvenir des noms de variables ou des signatures de scripts. Pour corriger ça, j'ai créé le WritingDoc Assistant. C'est un daemon Python qui tourne en arrière-plan dans le container.
Il surveille mon _variables.yml et mon répertoire features/. Dès que je sauvegarde une modification, le daemon se réveille et génère des snippets IntelliSense VS Code à la volée.
- Je tape
v-et j'obtiens la liste de toutes les variables du projet avec leur valeur actuelle. - Je tape
feature-et j'obtiens la liste de tous les scripts d'automatisation avec leur documentation complète. - Je tape
r-et il a déjà scanné tous mes fichiers pour me proposer des références croisées vers chaque titre et chaque figure du projet.
C'est comme avoir un bibliothécaire dédié qui vit dans mon éditeur et observe chacun de mes gestes pour me simplifier la vie.
Le daemon est démarré dans mon Devcontainer via la commande nohup, ce qui garantit qu'il tourne en arrière-plan sans bloquer le processus principal. Il surveille les changements en continu et met à jour les snippets en temps réel, pour une expérience toujours à jour. C'est un vrai bond en productivité.
Centralisation à grande échelle
Passer à 50 projets impliquait de ne pas avoir 50 configurations différentes. J'ai tout centralisé :
_variables.yml: le « cerveau » du projet. Chaque nom, chaque lien, chaque réglage est ici. C'est la source unique de vérité.update_chapters.py: un script que j'ai écrit pour maintenir la sidebar Quarto. Il respecte la numérotation des dossiers et ignore les dossiers « draft », pour une table des matières parfaite à chaque fois.- Le glossaire : un seul fichier YAML qui génère un glossaire alphabétique, avec ancres, sur l'ensemble du site.
- Les références globales : un fichier central pour toutes les URL externes, pour ne jamais chercher deux fois le même lien.
Le résultat
Aujourd'hui, quand je démarre un nouveau projet, je lance une seule commande : scaffold. En quelques secondes, j'ai une structure complète adaptée à ma stack.
La documentation n'est plus un monument statique dédié au passé. C'est un reflet vivant du code. C'est rapide, c'est sécurisé, et c'est beau.
Voilà la puissance de la documentation ingénierée. On ne se contente plus d'écrire ; on compile notre savoir.
🎖️ Un dernier mot : pourquoi Quarto change tout
Rien de tout ça ne serait possible sans le travail visionnaire des développeurs derrière Quarto.
L'équipe Quarto a eu l'intelligence et la clairvoyance de construire quelque chose de différent : un pont entre le récit et l'exécution.
En nous permettant d'exécuter du vrai code (Python, R, Julia) directement dans le cycle de vie du document, ils ne nous ont pas simplement offert une meilleure version de Pandoc. Ils nous ont donné un moteur de documentation extensible. C'est précisément cette capacité — lancer un script, analyser une API ou scanner un système de fichiers pendant le build — qui m'a permis de construire l'écosystème « WritingDoc ».
Aux développeurs de Quarto : merci pour votre travail extraordinaire et pour avoir offert au monde un outil open source qui permet enfin aux rédacteurs techniques de travailler comme des ingénieurs logiciels. Vous avez transformé la « corvée » de la documentation en une discipline d'ingénierie haute fidélité.
Cet article fait partie de la série Découvrir Quarto :
- Exécuter Quarto Markdown dans Docker
- Affichage conditionnel avec Quarto
- Utiliser Quarto pour créer un diaporama PowerPoint
- Utiliser des variables depuis un fichier externe dans votre projet Quarto
- Quelques astuces pour Quarto lors du rendu en diaporama reveal.js
- Les blocs Callout de Quarto
- Le short code includes de Quarto
- Style inline avec Quarto
- Mes extensions Quarto préférées
- Utiliser le templating Mustache avec Quarto
- Rendez votre projet Quarto prêt pour les Devcontainers — fini les galères de configuration
- Quarto - Comment j'ai construit un écosystème auto-documenté pour plus de 50 projets
Chargement des commentaires…
Articles liés


Dessiner une carte de mon propre blog
8 octobre 2026

Obtenir une mindmap plus attrayante avec Markmap et Quarto
25 juillet 2025